材料库

Humanoid Mobility via Attention-based Contacts
Junzhe He · Kehan Wen · Chong Zhang · Clemens Schwarke · Zewei Zhang · Kaixian Qu · Siyuan Hu · Matthias Müller · Vladlen Koltun · Marco Hutter
值得记住的是“保留示范中的接触结构,释放连接接触的全身运动”这一接口设计。它让单个 G1 策略在部署时摆脱参考轨迹,同时支持手、肘、膝等多部位协同。八个复合课程的仿真平均成功率达到 92.5%,但本文还没有证明开放三维场景中的通用移动或可认证的实机可靠性。

Agentic World Action Models
Zhuoyang Liu · Dantong Niu · Botong Zhang · Boning Shao · Jing Wang · Ruijie Zheng · Yuvan Sharma · Runyu Lu · Jiaming Liu · Renrui Zhang · Roei Herzig · Yutong Bai · Ken Goldberg · Danfei Xu · Yuke Zhu · Guanzhi Wang · Linxi Jim Fan · Trevor Darrell
AW-0 值得记住的贡献,是让可复用技能程序成为世界动作模型内部的规划表示:语义计划既影响未来画面,也影响运动控制。八项真机任务平均评分从最强基线 DreamZero 的 46.0% 提高到 71.1%,但视觉随机化仍明显破坏默认模型表现。它提供了连接程序技能与连续控制的可行接口,尚未实现交互中自主扩展技能或持续学习。

Phoenix(MWA™-Phoenix): Scaling Robotic Manipulation through Visual and Interaction Representations
Anyverse Dynamics · OpenPhoenix Team · Yupeng Zheng · Zhongpu Xia · Chaoyue Li · Linbo Wang · Xiang Li · Zebin Xing · Qichao Zhang · Haoran Li · Dongbin Zhao
无界动力开源的 MWA™-Phoenix 是目前综合榜单表现最强的开源机器人世界动作模型(WAM)基座:约 6B 联合视频—动作骨干,仅 RGB 输入、不用深度真值,在 LIBERO-Plus、LIBERO-Pro、RoboCasa-GR1、RoboTwin 2.0 C2R、Bench2Dex、RoboDojo 真机六项各有侧重的评测上同时登顶或最优。真正值得记住的不是单点分数,而是它把“几何+时序双教师蒸馏的视觉表征”“运动与触觉共同编码的交互潜变量(ILA)”“视触觉世界模型里的 GRPO 强化学习(PhysCanvas)”连成了一条从大规模预训练到真机精细操作的完整链路,且预训练数据全部来自开源数据集、代码与权重开放。对关注 WAM 预训练配方、接触操作和“世界模型内 RL”的读者,这是当前最完整的开源参照系。

Learning the 4D World through Point Trajectory Forecasting
Byungwoo Jeon · Sunghwan Hong · Dohyeon Kim · Jonghoon Lee · Jungwoo Park · Inhee Lee · Doosan Baek · Jinil Kim · Taehyun Lim · Hanbyul Joo · Marc Pollefeys · Saining Xie · Jinwoo Shin
值得保留的是一条受控证据:预测同一物理点的未来三维位置,能同时改善多视角视频的一致性与动作模型的操作表现。贡献包括联合监督机制、数据集与评测,但尚不能据此认定模型掌握完整物理规律或具备可靠的零样本轨迹控制。

T-WLA: Bridging Slow Vision and Fast Touch
Kaichen Zhou · Yuzhen Chen · Hannah Yao · Chonghe Jiang · Rao Fu · Xihang Yu · Wei Dai · Bashar Kabbarah · Haoyu Chen · Ishita Goluguri · Zhiyang Dou · Haonan Chen · Fangneng Zhan · Mengyu Wang · Wojciech Matusik · Antonio Torralba · Paul Pu Liang
T-WLA将视觉规划与触觉修正拆成两个时钟:39.7 Hz视觉分支输出基础动作块与历史视觉记忆,119.1 Hz轻量触觉编辑器读取缓存,修正未执行动作。未来图像和压力预测只在训练时监督表示,部署时移除预测头。EgoTouch手指MPJPE由0.50降至0.35 cm,真机四任务平均成功率50%。但自身无触觉版本已达47.25%,不能把相对SmolVLA+Tactile的33个百分点全部归因于快触觉。

Physical Words: A Vocabulary for Structuring Latent Reasoning in Robot Manipulation
Jiaming Liu · Xinghao Zhu · Yiming Zhang · Shanghang Zhang · Yinxi Wang · Yichu Yang · Zhuoyang Liu · Dantong Niu · Soha Pouya · Juekun Li · Yan Chang
值得记住的是用离散动作语义组织连续未来动力学的接口。PhysWord 在 UniVTAC 达到 90.3%,LIBERO-Long 达到 99.6%,四项真机任务平均 71.7%;长任务消融为语义锚点的价值提供了比可视化聚类更直接的证据。它尚未证明开放词汇技能组合或任意无触觉部署。

No Eyes, No Problem: What Does Touch Contribute to Blind Baoding Ball Manipulation?
Ayush Deshmukh · Nalin Agarwal · Elle Miller · Sethu Vijayakumar
这篇论文回答一个很具体的问题:在完全不用视觉和物体状态估计的前提下,灵巧手仅靠本体感觉和二值触觉能做多久的双手内保定球旋转?答案是:在 Shadow Dexterous Hand Lite 上,策略零样本从仿真迁移到真机,单次连续试验完成 225 个 180° 旋转(112.5 整圈),约 0.36 rot/s,是迄今保定球操作最强的硬件结果。能迁移的关键不是更大的模型,而是三件事:把 Isaac Lab 默认资产里错误的 PIP/DIP 固定比例耦合改成硬件真实的顺序耦合;提出两种 episode 级随机化——SlewDR(动作斜率限制随机化,让策略学会硬件跟得上的平滑动作)和 STAT(随机把若干触觉通道整 episode 卡死在 0 或 1,迫使策略不过度依赖单一通道);再加上基于空手基线的迟滞双阈值触觉标定。消融显示触觉的主要贡献不是产生动作节律(本体感觉策略自己就有节律步态),而是把名义步态修正成完成的旋转并在球位偏离时恢复:同一 checkpoint 关掉触觉后,整圈数从 34.75 掉到 5.0。

Blind Precise Assembly: Proprioceptive Sim-to-Real Peg-in-Hole for Diverse Parts
Antonia Bronars · Younghyo Park · Kushal Kedia · Pulkit Agrawal
关节编码器不仅记录手臂在哪里,也记录运动怎样偏离命令。本文证明,这种间接接触通道足以支撑局部精密装配:策略只读0.6秒关节位置、速度、由正运动学得到的夹爪状态及上一步动作,不读图像、力、力矩、触觉、孔位或零件模型。纯仿真PPO学会插孔、齿轮啮合和螺母起扣;插孔在真实机器人上无需微调,八种零件237次测试成功173次,即73%。 三项设计相互配合:mjfit程序化生成保持间隙的碰撞几何;历史编码器从动作后果推断接触;训练期接触标签辅助表示学习。更耐受未见几何不代表未知零件已解决:随机凸截面盲策略36.2%、视觉3.9%。真实实验仅覆盖插孔,所有任务从零件已接触夹具的位置开始。

Value as Memory: Online Value-Guided Post-training for General Robot Policies
Wenye Yu · Yijin Chen · Kaiyi Xiong · Wenbo Han · Wendi Chen · Yang Jin · Han Xue · Jun Lv · Cewu Lu · Chuan Wen
VaM 把近期价值预测从训练标签变成策略可读取的任务进度记忆,同时用离线演示、历史人工干预和当前在线 rollout 持续更新价值与动作专家。三项真机长时程任务中,价值缓存相对消融在最终三个检查点上平均提高 29.4 个百分点;在线 RL 在匹配预算下经 LfE 后平均超过离线 RL 32.8 个百分点,并把每梯度步实验墙钟时间降低 57.8%。这是“critic 参与推理”与“提高部署—训练闭环频率”的双重贡献,但证据仍限于单机器人、三项实验室任务和可靠价值估计,不应外推成通用无人值守自我进化。

When Do Discrete Actions Make Good Continuous Controllers?
Zeji Yi · Soham Dasgupta · Xinyang Zhang · Koushil Sreenath · Guannan Qu · Xi Chen · Max Simchowitz · Guanya Shi
这篇工作的价值在于重新定位动作表示的瓶颈:在所测机器人任务中,简单离散动作并不天然输在精度,反而能保留连续回归容易平滑掉的细节;真正需要解决的是跨时间、跨坐标的行为一致性。RoboCasa 上单步离散回归加入 CFG 后成功率由 27.1% 提升至 49.2%,接近离散流 53.9% 和连续流 52.7%。这是设计 VLA 动作头时值得保留的证据,但不是“离散动作在所有精密控制问题上都更优”的定理。

LoopWAM: Closed-Loop Generalist Policy Improvement from Deployment Rollouts
Wenxuan Guo · Yingping Liang · Zhaoguo Wang · Zhenyu Wu · Chengkun Wang · Xiuwei Xu · Meng Zhang · Bingyao Yu · Ze Chen · Ziyuan Li · Angyuan Ma · Borui Zhang · Jiwen Lu · Erjin Zhou
LoopWAM 回答的问题是:通用机器人策略部署之后,能不能直接吃自己(以及别人)跑出来的全部 rollout——包括成功、次优和失败——而不用先过滤再模仿。它的答案是三个机制装进一个双流世界-动作模型:source-dependent noise sampling 让低噪声的记录动作充当后果预测的条件,把 ACWM 折进同一训练阶段;quality steering 把轨迹质量写成指令后缀 `Quality: q`,部署时只用专家分 q⋆ 采样;quality-weighted supervision 给动作损失乘权重 λ(q),失败轨迹 λ=0 但保留视频监督。 效果是真闭环:RoboChallenge Table30-V2 四种本体 30 个任务上三轮“部署-重训”把总成功率从 23.67% 拉到 43.33%(+19.7 个点),总分 56.80 登顶榜单;不做额外具身预训练就在 RoboTwin 2.0 拿到 94.5% 平均成功率、RoboCasa365 拿到 49.5%;叠衣服单任务后训练两轮从 13.20% 到 55.56%。消融显示 quality steering 是最大单项增益来源(无 steering 时平均仅 72.3%),而且粗粒度标注(每个 checkpoint 一个分)就已足够。

FACT:面向人类到机器人灵巧迁移的力—动作—轨迹基础模型
Zhi Cao · Yining Hong · Jiaolong Yang · Yejin Choi · Li Fei-Fei · Jiajun Wu · Huang Huang
FACT 值得记住的是:人类示范能传递的不只是运动轨迹,还有接触如何随动作变化的经验。它在每任务仅 10 条机器人示范、配合 90 条人类示范的条件下,显著优于 T-Rex,但七项二元任务平均成功率仍只有 41.4%。这是带力人类预训练和接触预测的有力实验,不是通用灵巧操作已经解决的证据。

Delta Flow Matching for Robot Foundation Models
Kuangji Zuo · Tuo An · Xinying Guo · Gen Li · Mengfei Zhao · Jiaqi Bai · Bofan Lyu · Zhuoyuan Yu · Jinghan Yang · Jiayi Li · Jindou Jia · Jianfei Yang
这篇论文的核心改动不是换掉 VLA 或 WAM 骨干,而是换掉 flow matching 的起点:不再从纯 Gaussian 噪声生成未来动作和未来视觉潜变量,而是把最近执行过的动作、当前或近期视觉潜变量加上有控制的噪声作为源分布。于是模型学习的 transport 从“任意噪声到未来”缩短为“过去到未来的残差变化”。作者把这个策略接入 `π0.5`、ImageWAM 和 Fast-WAM:ImageWAM 一个 epoch 达到 91.30% LIBERO 成功率,比原模型提前约 6 倍跨过 90%;Fast-WAM 提前 4 倍达到 95% 以上;`π0.5` LoRA 一个 epoch 的 92.20% 已超过 Gaussian 十步基线五个 epoch 的 91.30%。单步推理在三个模型上分别带来 1.54×、2.49× 和 4.45× 加速,同时把单步 Gaussian 采样的动作 jerk 降低 4.5×。 strongest evidence is LIBERO-Plus:ImageWAM 从 82.49% 提到 88.55%,`π0.5` 从 80.70% 提到 84.53%。

UNITAS: A 3D-Native World Action Model for Embodied Manipulation
Ruixiang Wang · Yongyi Su · Wenlve Zhou · Bo Yue · Hengyan Liu · Dekun Lu · Yuxin Tian · Yihan Fang · Zerui Wu · Xing Hu · Jietao Chen · Yong Guo · Ziyan He · Junbin Yuan · Guiliang Liu · Xiaofen Xing · Kui Jia
UNITAS 不是把深度图简单接到 VLA 上,而是把“看见什么、身体怎么动、世界如何响应”都写成同一度量 3D 坐标系里的点轨迹。机器人夹爪和人类手被表示为 action flow,环境点位移被表示为 scene flow;一个物理时间 tokenizer 让不同采样率与轨迹长度的数据共享接口。1.7B 模型在 LIBERO 达 99.8%,LIBERO-Plus 达 89.1%,RoboTwin Clean/Randomized 达 92.94%/93.04%;在动作条件场景预测中,Moving ADE 从 PointWorld 的 0.656 cm 降到 0.427 cm。
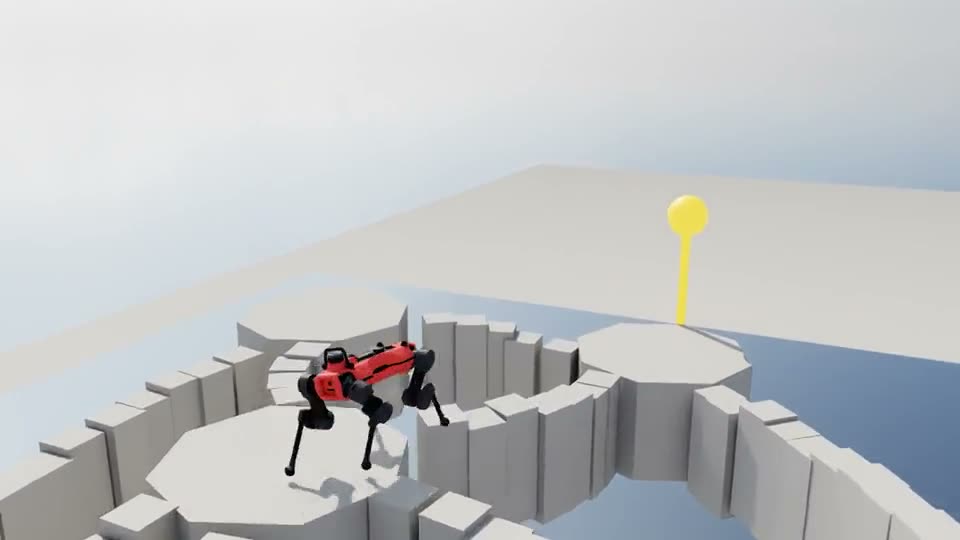
A Balanced Data Diet: Addressing the Exploration Bottleneck in Mega-Scale RL for Robot Control
Octi Zhang · Mateo Guaman Castro · Patrick Yin · Ignacio Dagnino · Abhishek Gupta · Rosario Scalise · Byron Boots
SGS(Success-Guided Sampling)解决的不是“新的策略网络”或“新的 PPO 更新规则”,而是大规模并行 RL 里经验分配的瓶颈:uniform reset 会把大量环境浪费在策略已掌握或完全解不了的配置上。它为每个固定任务配置维护最近 100 次布尔成功记录,用 Beta 形核给中等成功率区域更高权重,再经 softmax 抽样,同时用数值下限保证困难配置仍会被偶尔重访。作者在最多约 1M 并行环境的仿真中验证:1M 环境下多地形 ANYmal-D 成功率约 73%,高于 PLR 的 54%;Franka 螺母装配约 70%,而 uniform 和 PLR 分别约 6% 和 5%。不过,操作任务是逐任务训练策略,不是单个通用策略;实机 UR5e 三个任务零样本成功率从 37.5% 到 94% 不等,sim-to-real 差距仍真实存在。

RoboRSI: Stable, Efficient, and Reusable Robot Self-Evolution in Complex Real-World Environments
Zimo Wen · Yijin Chen · Yuxuan Cao · Wendi Chen · Yanwen Zou · Wenye Yu · Fuhang Kuang · Han Xue · Jun Lv · Chuan Wen · Cewu Lu
RoboRSI 的核心不是一个新的端到端机器人策略,而是一套让执行经验变成可维护能力的系统机制。它把任务组织为任务族、复合技能、原子任务和基础技能,要求每个节点有明确接口、责任和后置条件;失败后由 Reviewer 沿实际调用路径定位最早失败节点,Manager 只允许在这个节点拥有的子树内修改,并通过功能测试与近期执行回放验证后才发布。这个“先定位责任、再局部修改、再门控发布”的流程,显著减少了修补漂移和全局技能库污染。 证据上有两点最值得记住:其一,在 104 轮、24 小时真机移动清理开发中,系统把失败修复转化为技能树中的局部能力和回归测试,最终两个场景 9 次指定放置全部由现场人员确认成功且无人工接管;其二,复合技能消融在 600 个匹配 episode 上将成功率从 21.5% 提升到 29.0%,同时中位 token、模型调用和墙钟时间分别下降 29.4%、27.2% 和 17.0%。但主仿真结果是在线自我改进口径,不能和固定策略 Pass@k 混读;真机曲线也是开发记录而非固定任务重复实验。

TACROSS: An Efficient and Low-Cost Scalable Human Touch System Across Heterogeneous Tactile Sensors for Dexterous Robot Learning
Bo Chen · Huanzhang Hu · Junyang Ma · Bo Yue · Fangdi Yu · Haijier Chen · Xianxin Lai · Shuyu Pan · Zhen Yang · Xiaoquan Sun · Wenze Cui · Zhongliang Jiang · Shaopeng Liu · Jiayu Chen
TACROSS 用 10.86 美元的压阻手套快速采集人类触觉示范,并通过接触事件语义而非原始 taxel 数值对齐到电容式 Revo2 机器人手,再由少量机器人执行示范提供动作真值。

TouchScale: 500 Hours of Human Vision and Touch for Visual-Tactile Learning
Dayou Li · Hao Wang · Qianqian Yang · Zihao Zhu · Haoquan Fang · Ziyao Zeng · Yan Han · Zihan Wang · Yan Wang · Baoru Huang · Dilin Wang · Kenji Shimada · Yiyue Luo · Manling Li · Teresa Lv · Mustafa Mukadam · Rakesh Ranjan · Ruohan Zhang · Qi He · Changliu Liu · Xu Chen · Marco Pavone · Bangya Liu · Jiachen Li · Masayoshi Tomizuka · Zhiwen Fan
值得关注的是统一采集管线下的人类触觉数据规模,以及无动作标签数据对真实机器人策略的可测收益。500 小时数据中训练后,四项真机任务平均成功率从 22.5% 增至 57.5%。证据支持这一数据路线继续扩展,但尚不足以证明通用接触动力学或跨机器人本体泛化。

Long-WAM: Scaling the Context of World-Action Models
Wei Huang · Bohan Zhang · Chenzhi Liu · Isabella Liu · Shuai Yang · Weian Mao · Luozhou Wang · Yicheng Xiao · Weifeng Lin · Qixin Hu · Bryan Chu · Sifei Liu · Linxi Jim Fan · Xiaojuan Qi · Song Han · Yukang Chen
这篇论文的核心不是简单把 WAM 的观察窗口拉长,而是证明“能访问历史”和“会用历史”不是一回事。Long-WAM 先用约 10,000 个窗口等价小时的无动作机器人/自我中心视频做自回归预测预训练,让视觉骨干学会从过去帧预测未来交互;再在动作适配时保留同样的因果顺序,让动作专家以观察历史和部分去噪的未来潜变量为条件。结果是,GR-1 上 0 到 19.2 秒历史把成功率从 63.3% 提到 78.7%,而双向预训练初始化没有净收益。与此同时,流式 VAE、异步动作块执行、NVFP4 量化、KV 复用和设备特定调优让 RTX 5090 上包含未来视频预测的完整动作块推理降到 107.4 ms。真机动态杯堆叠达到 19/20,而 `π0.5` 和 Fast-WAM 都是 0/20。

World Action Learning via Interaction-Centric Spectral Latent Guidance
Zhiming Liu · Yikun Miao · Ying Chen · Hongrui Yin · Fangqi Zhu · Xiaoyi Pang · Quanxin Shou · Zhengyang Yan · Haodong Wang · Song Guo
WING 把第一人称人类视频中的可迁移操作知识蒸馏成两类结构:先剔除观察者相机运动、保留手-物交互 latent action,再只取跨本体更一致的 DCT 低频成分作为动作生成 guidance。它在 LIBERO、RoboTwin 2.0、RoboCasa-GR1 和真机双臂任务上都取得强结果;消融显示去观察者偏差与低频谱引导分别有效,且组合最优。

EmbodiRSI: Recursive Self-Improvement for Data-Efficient Robot Adaptation
Haoran Lang · Haotao Lu · Shiyu Sang · Haoyang Luo · Guo Chen · Qun Li · Jingyi Yu · Ye Shi · Jingya Wang
EmbodiRSI 的价值在于把“当前策略失败在哪里”变成下一批训练数据从哪里来。它先从目标真实桌面重建一个可反复复位、诊断和采数的任务仿真;策略 rollout 时,agent 监控失败并从策略已经到达的中间状态生成纠正轨迹;跨 episode 后,再把失败归因到源物体或目标锚点的空间弱区,定向补采专家示范。两轮更新后,14 个子任务的 scene-balanced 自主仿真成功率从 50.4% 升到 83.5%;用 400 条自适应仿真轨迹加每个子任务 10 条实机人工纠正,实机成功率达到 83.1%,高于每个子任务 200 条真实示范的 75.0%。 这篇论文的“递归自我改进”不是模型自己改写权重或代码,而是外部 agentic 工作流根据当前策略的 rollout 反馈,递归改变经验获取、纠正监督和后续训练。评估限制也很清楚:三个目标桌面场景、每个策略覆盖一个场景、代码尚未发布、没有 held-out 场景和长时间持续改进验证;实机每个任务只有 10 次测试,统计证据仍是原型级而非跨场景结论。

Unified Visual-Tactile-Action Modeling from Human Demonstrations for Dexterous Manipulation
Wenqiao Li · Qianyou Zhao · Jiawen Hao · Xuezhou Zhu · Tengyu Liu · Kaifeng Zhang · Chuan Wen · Siyuan Huang
UVTA 的核心贡献是把“人类触觉示范”变成机器人灵巧操作的可扩展监督。它不要求人手动作直接可执行,而是把人类与机器人轨迹统一到 20 维触觉、31 维动作空间,并让共享视觉-触觉表征同时预测未来动作和未来触觉轨迹。真机五任务上,UVTA 的平均阶段化成功率为 70%,高于最强视触基线 T-Rex 的 29%;人类数据从 0 增至 1,000 条时,三任务平均从 0% 升至 84%,且曲线在 1,000 条尚未饱和。它的价值在于提出了比本体形态更稳定的“接触物理后果”作为跨本体迁移接口。

RoboFoundry: System-as-Policy Evolution for Self-Learning Embodied Agents
Jingsong Liang · Shuhao Liao · Shizhe Zhang · Diyuan Hou · Yuxin Cai · Xinjian Deng · Chengyang He · Wenhui Huang · Runjia Tan · Zhidong Wang · Lan Yu · Xuesong Tian · Guillaume Sartoretti · Jie Luo · Yao Mu · Wenjun Wu · Wanhua Li · Chen Lv
RoboFoundry 的关键转向是把 “embodied policy” 从基础模型本体扩大为围绕模型运行的完整系统:进入模型的活动上下文、跨 episode 文件记忆、原子技能与复合技能、恢复树、语义/执行绑定,以及记录这些组件如何被调用的 trace,都成为可以诊断和修改的对象。基础模型权重保持冻结;所谓 self-evolving 是系统文件、规则、接口和技能库在被执行反馈验证后持久更新。 它的外循环是 Act–Reflect–Repair–Promote:先执行并记录 trace,再把失败归因到 perceive / reason / plan / save / retrieve / utilize 六类能力,随后生成任务级修订;如果同类能力的其他任务 held-out trace 没有退化,才把任务经验抽象成通用系统规则。这个设计把组件级优化提升到系统级优化,同时用显式 scope 和验证避免无约束自我改写。实验覆盖 1,128 个 EmbodiedBench 任务、RoboMemArena、LIBERO-PRO 和真实机器人;GPT-5.5 平均成功率从 56.9% 提升到 72.7%,Qwen3.7-Plus 达到 70.3%,真实机器人上也能跨任务和跨本体继续演化。

See to Reach, Feel to Grasp: Learning A Blind Grasp Reflex for Anthropomorphic Robotic Hands
Alexander Alexiev · Tzu-Yuan Lin · Sang Min Kim · Ho Jae Lee · Yonghyeon Lee · Sangbae Kim
值得记住的是一种可复用的手部抓握接口:机械臂负责把手送到物体附近,手只凭关节反馈完成接触适应,并主动报告何时可以开始搬运。仿真中的动态与位置泛化明显优于本文适配的端到端基线,但真机只是多样性和组合能力演示,没有重复试验成功率,不能把它当成已验证的通用可靠抓手。
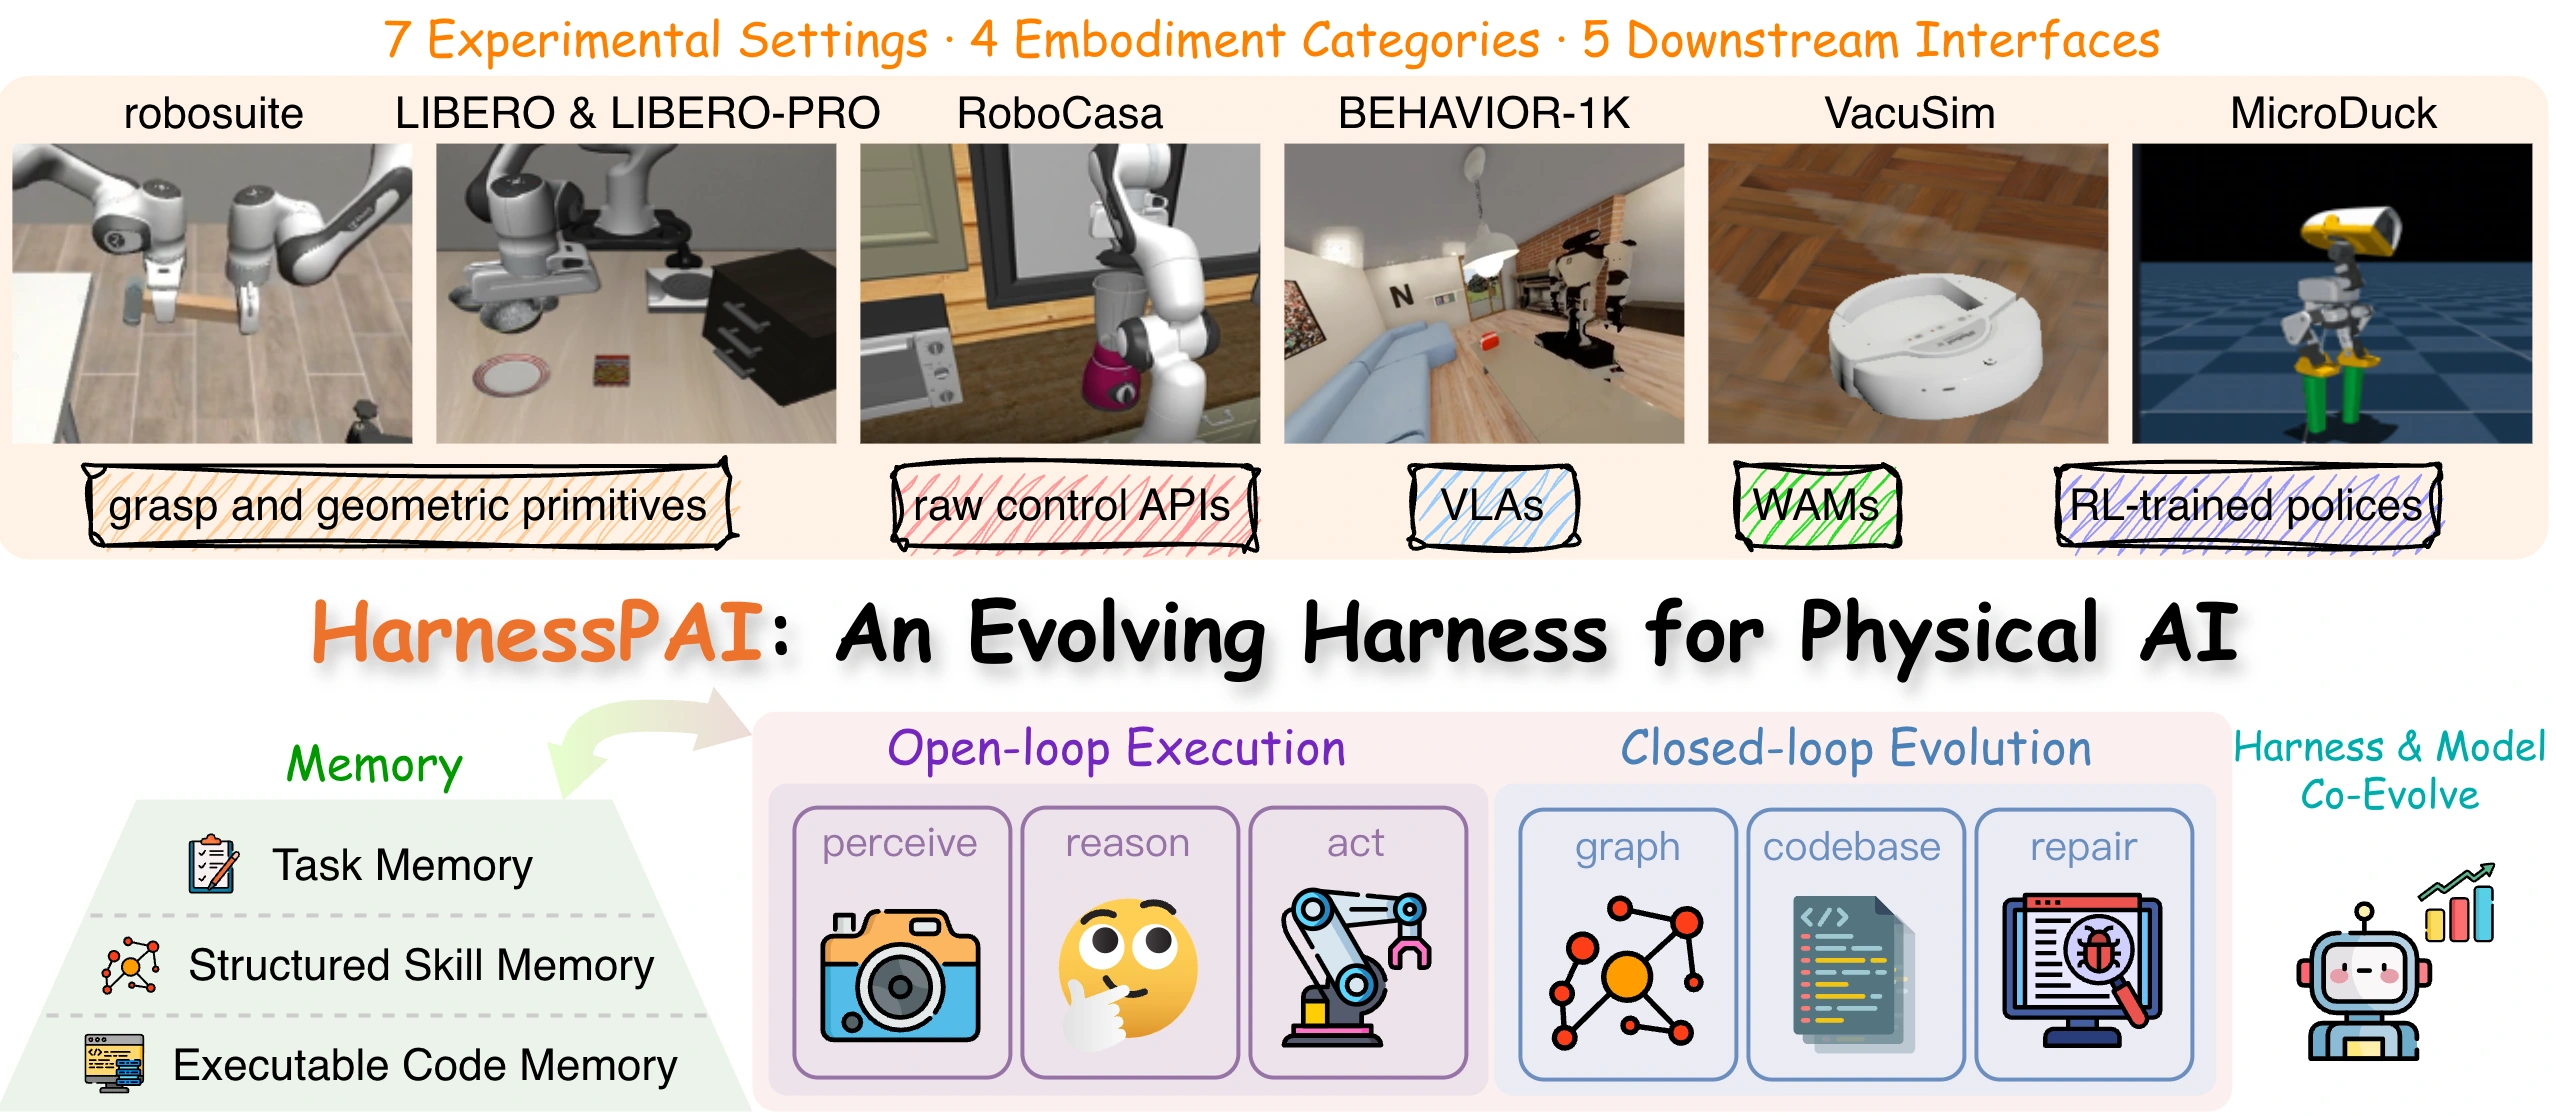
HarnessPAI: An Evolving Harness for Physical AI
Xin Wang · Wenhao Wu · Menghao Zhang · Zhi Wang · Kun Shao · Jian Luan · Yang Li · Qing Li · Shangding Gu · Huichi Zhou · Shuqing Shi · Fei Ni · Shuo Lu · Weicheng Meng · Kang Li · Jin Wu · Kang Zhao · Shangmin Guo · Gen Li · Yongqiang Tang · Zhizhong Zhang · Yuan Xie · Heng Qu
HarnessPAI 的核心主张是:Physical AI 的瓶颈不只藏在 VLA/WAM 权重里,也在把感知、语言 grounding、几何推理、动作调用和验证组织起来的执行系统中。它把任务写成可执行程序;单次 rollout 内程序固定、逐步检查、没有在线高层 LLM deliberation;跨 rollout 则由代码轨迹、 rollout 视频和成功契约驱动程序演化,并把失败修复沉淀为按任务图节点检索的技能库。包装冻结的 π0.5 后,LIBERO-PRO 从 34.9% 升至 96.5%;包装 WorldDreamer 后,RoboCasa Atomic-Seen 从 65.0% 升至 92.2%。成功轨迹还能作为无人工标签的扰动场景专家数据,把 π0.5-LIBERO 的 LIBERO-PRO 成功率从 34.9% 微调到 73.7%。

Grounded Action Model: 3D Grounding as a Foundation for Robotics
Gehao Zhang · Weikai Huang · Shailesh Shailesh · Yiyan Peng · Jiafei Duan · Ranjay Krishna
Grounded Action Model(GAM)提出“3D grounding 是机器人基础模型预训练基础”的路线:不用语言生成或视频生成为主骨干,而是用冻结的 promptable 3D 检测器 WildDet3D 把语言、点击或框统一解析为任务对象的 2D 框、3D 框、深度图和视觉特征。动作头只学习如何作用于这些已定位对象,并用目标图像 token、点云检测 token、机器人状态历史和语言语义预测关节位置动作块。在只见过 clean scene 示范的条件下,GAM 于 RoboTwin 2.0 randomized 达 47.62%,平均 55.29%;LIBERO-PRO 16 项扰动平均 0.61;真机 YAM 视觉扰动下保留 17/20 成功,Franka 长程/记忆任务 OOD step completion 49.8%。

ForceDelta-VLA: Distilling Force-Conditioned Action Corrections for Contact-Rich Manipulation
Ju Dong · Yu Fu · Jian Chen · Yimeng Liu · Haocheng Zhao · Lei Zhang · Kaixin Bai · Liding Zhang · Diwen Zheng · Alois Christian Knoll · Angela P. Schoellig · Jianwei Zhang
ForceDelta-VLA 的关键不是再训练一个更大的 force-aware VLA,而是把慢速生成式动作块拆成“可复用参考动作 + 快速位姿修正”。冻结教师通过同一状态、同一视觉语言前缀和同一流噪声下的力条件/力无关成对预测,为无标注示范合成显式力修正标签;另一个延迟头学习参考块陈旧和参考状态变化带来的补偿。学生在 2.43ms 内输出五步位姿修正,九个单臂/双臂实机任务平均成功率 82.2%,高于 ForceVLA 的 54.4% 和时序教师的 70.6%,并在两个平台均降低约 26% 的成功试验平均峰值接触力。

rMuscle: Robotic Muscle Memory for Efficient Vision-Language-Action Model Inference
Kaijun Zhou · Zhiyang Li · Le Chen · Jinyu Gu
值得记住的不是“机器人记住动作”,而是重复工位任务能提供可复用的内部计算模式。rMuscle 在强推理引擎之上进一步降低延迟,RoboTwin 平均成功率及两项真机成功率持平;收益依赖参考覆盖、硬件瓶颈和重建时间,不能直接外推到开放世界。

WM-Craftnet: World Synesthesia Model for Generalizable and Robust Dexterous In-Hand Manipulation
Jie Yin · Zeyuan Zhao Xiaojing · Tan Yang Liu · Chiyu Wang Xinyang · Sharpa Robotics
值得记住:论文把世界模型从“想象轨迹优化器”改造成可部署的递归状态编码器,并用干净深度监督解决真实腕部深度噪声;在20个真实物体200次试验中成功175次。

OpenWAM: An Open, Modular Exploration Towards Systematic World-Action Model Pretraining
Yuran Wang · Siqiao Huang · Mingleyang Li · Chenhao Zhang · Jiaqi Liang · Weiyang Jin · Yue Chen · Xuemin Chi · Donghao Zhou · Qize Yu · Yu-Kai Wang · Yuhan Rui · Shenzhe Yao · Zhen Yuan · Zhenhao Shen · Kefei Zhu · Zijie Zhu · Ning Gao · Xiaowei Chi · Guanqi He · Shanghang Zhang · Hao Dong · Lin Shao · Hang Zhao
OpenWAM 最值得记住的不是“又一个视频生成模型改机器人策略”,而是它第一次把 WAM 的设计变量拆成可复现实验:骨干、潜空间、动作容量、世界/动作信息流、联合去噪和预训练数据配方分别控制,再把结论累积成一个开放模型。 论文给出的强结论是:WAM 需要足够强的视频生成先验和紧凑、高信息量的视觉潜空间;动作必须有独立容量并在训练时读取世界特征;推理时同步联合去噪优于人为安排“先想未来、再反推动作”;跨域预训练的主要收益是 OOD 泛化,而不是继续抬高接近饱和的 ID 分数。 OpenWAM-α 用约 6369 小时、5.185 亿帧的人类第一视角与异构机器人数据实现这套配方,在多数仿真和三类真机形态上达到强基线水平。但它在 LIBERO-Plus 只有 69.2%,相机扰动 33.8%、噪声扰动 39.8%,清楚暴露了“长时程像素潜空间预测 + 单臂数据覆盖不足”的 OOD 脆弱性。因此,这篇论文既是 WAM 的工程底座,也是比单纯 SOTA 宣传更有价值的失效边界报告。

CR-VLA-Force: Learning Control-aware Compliance VLA Model for Robust Contact-rich Robotic Manipulation
Zhaohong Mai · Chao Wang · Chao Zeng · Sitong Mao · Heng Zhang · Shunbo Zhou · Chenguang Yang
CR-VLA-Force 的真正贡献不是再给 VLA 增加一个力觉输入,而是把 1 Hz 的慢速 VLA 与 500 Hz 的自适应柔顺控制器组成分层闭环:模型联合预测位姿和前馈力,控制器用实时力误差连续调刚度。六个力觉/接触条件平均成功率达到 89.2%,高于 ForceVLA 的 73.2%;擦板 40 N 跟踪误差降到 5.52%(base)和 8.78%(OOD)。但它的泛化证据仅覆盖单台 UR5e、四类任务与有限位姿偏移,“安全”主要来自工程控制约束而非整个学习系统的形式化保证。

GE-Act 2.0: Pretraining and Scaling a World-Action Model for Robotic Manipulation
Renhang Liu · Wenzhi Zhao · Zhuo Yang · Liliang Chen · Pengfei Zhou · Shengcong Chen · Guanghui Ren · AgiBot Research Team
GE-Act 2.0 把 world model 的“预测未来画面”和 policy 的“输出动作”拆成可分别预训练、再可微分连接的两段,并用 KASO 解决“生成的未来与示范动作可能不是同一种正确行为”的监督错配。它最有价值的证据不是某个单点 benchmark,而是从 300 小时扩到 30,000 小时后,两个真实机器人上的零样本 OOD 操作成功率仍持续上升;但它目前仍是短视的 System-1 控制器,不等于开放环境中的完整机器人智能。

FWBC-VLA: Force-Aware Whole-Body Compensation for Contact-Rich Loco-Manipulation
Yutian Zhang · Siyuan Ma · Liwen Yang · Yang Li · Ce Hao · Haozhen Chi · Dong Wei · Qiaojun Yu · Dibo Hou
FWBC-VLA 值得记住的贡献是把“操作任务需要的接触”与“同一接触给移动机身造成的负担”放进同一闭环。它在轮足四足机器人上实现擦白板 64%、开门 52% 的完整任务成功率,均比 ForceVLA 高 40 个百分点。证据支持低成本接触反馈与机身补偿协同的工程价值,但尚不足以证明精确六维测力、跨机器人泛化或通用的任务力/外部扰动辨识;论文 v2 还有数处正文—表格冲突,下面逐项标注。

VLA-Precision: Asymmetric Co-Bootstrapping for Efficient Real-World Online RL of Vision-Language-Action Models
Chenyu Su · Zhaolong Shen · Yuan Qian · Chen Qian · Rui Zhang · Feng Yan · Weixing Chen · Fei Zhang · Jiamin Wang · Shuang Cong · Weiwei Shang
VLA-Precision 的核心贡献是把真实世界 VLA 在线 RL 的两个瓶颈一起处理:ACoB 用“先快速吸收人类纠正、再逐步信任 critic”的非对称学习节奏抑制策略漂移,ACoB-Stream 则缓存冻结前缀的 KV context,只按需读取上下文并同步 LoRA 状态。九项高精度化学操作共 180 次测试成功 177 次,平均每任务在线训练 45.8 分钟后达到 98.3% 成功率;但这是任务级精修、持续有人类接管且使用 4 张 A800 的受控实验室证据,不等同于开放世界通用可靠性。

Facet-0: A Robotic Foundation Model for Contact-Rich Precise Manipulation
Haoyuan Deng · Haichao Liu · Wenkai Guo · Yuan Ling · Zaijia Yang · Yuanjiang Xue · Haosheng Sun · Liangzi Wang · Ziwei Wang
Facet-0 的关键不是把力觉当作又一个输入通道,而是让策略同时提出动作和该动作将引发的腕部力矩后果,再用接触结果训练分布式价值模型、按接触阶段分配强化学习信用,最后用受安全边界约束的小型 actor 做任务级适配;在五项亚毫米电脑装配任务上达到 82% 平均成功率,而最强基线为 15%。
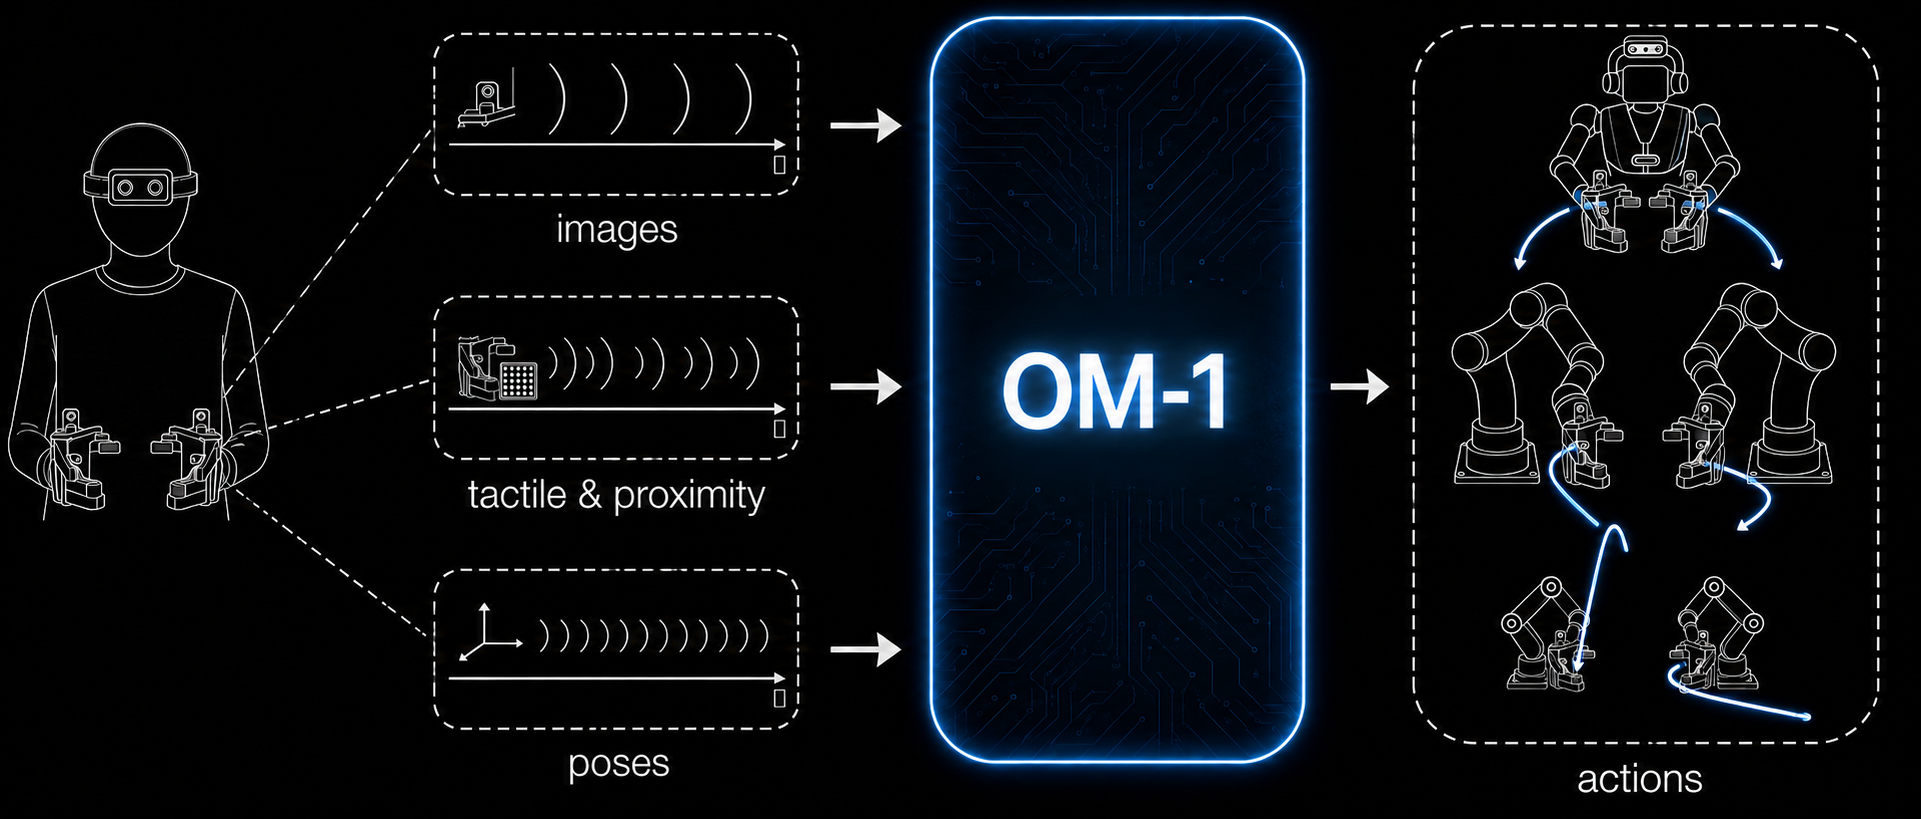
OM-1 最值得研究的是“怎样把人类操作保真地记录下来,并让不同机器人实时执行”这条完整链路。它用 Omnibody Hand 采集人类示教,由多模态策略产生动作,再由仿真强化学习得到的控制层执行。“策略只学人类数据”与“控制器使用仿真 RL”属于不同层次。 现有材料支持把它视为一个有吸引力的系统方向;尚不足以复现网络,或证明在标准基准上超过其他通用策略。

Motus2: A Self-Evolving General World Model for Dexterous Manipulation
Hongzhe Bi · Zihao Zhou · Yihang Tang · Jingrui Pang · Shuhe Huang · Haitian Liu · Runqing Wang · Shuai Huang · Yichen Wang · Yiming Cheng · Ruowen Zhao · Zhenghua Li · Hengkai Tan · Xiaolong Liu · Jinhui Wan · Jiabao Liu · Min Zhao · Fan Bao · Jun Zhu
Motus2 值得记住的不是“又一个更大的 VLA”,而是它用同一套共享参数实现 policy、simulator 和 evaluator,再把三者闭合成可规划、可更新策略的控制回路。受控实验中,第一视角预训练把五项真机任务平均成功率从 0% 提到 51%,机器人域 mid-training 进一步提到 84%;MBRL、长时记忆和触觉反馈也分别给出可量化增益。但这里的“自进化”仍是受控的模型式后训练,而不是机器人在开放环境中无限自主成长。

Beyond Data Scaling: Representation-Centric Continued Pre-training for Vision-Language-Action Models
Senqiao Yang · Chengyao Wang · Yuxin Chen · Zixuan Wang · Longxiang Tang · Haokun Gui · Jinhui Ye · Changsheng Lu · Xiaoyang Wu · Mingkang Zhu · Pengguang Chen · Shu Liu · Zhuotao Tian · Hengshuang Zhao · Bei Yu · Jiaya Jia
VLAct 说明 VLA 的下一条独立增长轴不只是继续堆机器人轨迹,而是改造 continued pre-training 如何塑造 backbone 表示。在固定下游微调协议下,它仅替换预训练后的 Qwen3-VL-4B backbone,就在多项仿真、真机与未见 embodiment 迁移任务上取得 7.6–21.4 个百分点增益;最值得记住的是“保护 VLM 先验、用多动作头抵抗 decoder lock-in、只在物理可比维度共享动作语义”这套配方。

TacForcing: Streaming Action Generation with Execution-Time Tactile Feedback
Jianbo Zhou · Boyuan Zhao · Yuzheng Zhang · Yiyang Chen · Wenxin Chen · Qiuyue Li · Xiangyang Gu · Yuhan Cao · Xiao Xia · Yanzhe Hu · Zhijie Deng
TacForcing 解决的不是“VLA 能否看到触觉”,而是“动作块执行到一半时,最新触觉能否继续改写尚未执行的动作”。它把一个动作 chunk 拆成顺序完成的块,保留未来块的 flow-matching 中间态,并用执行后新采集的触觉继续细化;EATA 只让最新触觉影响下一块,避免它提前污染更远期动作。六个 UniVTAC 仿真任务平均成功率 65%,三个真机任务平均 69%,但 v1 的真机评测每任务仅 16 次,尚不足以证明跨硬件泛化或实时成本优势。

What Matters for Latent Actions in Robot Learning
Xizhou Bu · Qingda Hu · Lei Zhou · Lingfeng Zhang · Yingbo Tang · Zihao Liu · Xinyi Tao · Zhiqiang Ma · Qingqiu Huang · Chufeng Tang · Hongbo Wang · Jing Zhang · Jiayi Ma · Hangjun Ye · Wei Li · Xiaoshuai Hao
这是第一篇对 latent action model(LAM,隐式动作模型)做系统性实证研究的论文:把 LAPO、LAOF、CoMo、CFD-AE 等代表方法统一进同一个自编码框架,系统扫描了 41 个设计选择(建模范式、学习目标/正则化、隐式动作集成方式),并检验了 4 个代理指标能否预测下游操纵性能。核心结论是**原始 LAPO 反而是最强基线**,光学流(RAFT/SEA-RAFT)这类运动先验反而有害,隐式动作在 VLM 骨干微调后能显著提升下游策略与真实机械臂性能(真机成功率 64.75% → 79.25%)。对做「用无标注视频训练机器人」方向的人,这是一份可直接照抄的配方表。

ADEPT: Accelerating Dexterity via Pre-Training and Post-Training using Reinforcement Learning
Jayjun Lee · Jessica Yin · Asif Rana · Nicholas Blauch · Sam Mady · Mohak Bhardwaj · Nima Fazeli · Nathan Ratliff · Karl Van Wyk · Ankur Handa
ADEPT 把高自由度灵巧操作学习拆成“通用预训练 + 稳定后训练 + 感知蒸馏”三层:先用 8B 环境步在 16 类几何 primitive 上训练 reposing 教师,学到 reach、grasp、lift、in-hand reorient、transport 等可复用技能;再把教师迁移到 FMB peg insertion 与 dish-rack placement,用 actor 蒸馏、critic warm-up 和低学习率 PPO 避免灾难性遗忘;最后蒸馏成只看 RGB 或 RGB+五指触觉的学生策略,零样本部署到 23 DoF Kuka-Allegro 和 29 DoF Flexiv-Sharpa。关键实验结论是:直接 PPO 微调会迅速把预训练能力打到 0%,而 ADEPT 后训练在 3B 步内得到稳定教师;真机长程任务中,视觉学生取得 3/10–6/10 成功率,加入指尖触觉后同一 Flexiv-Sharpa 方形/圆头插入任务提升到 8/10。这个结果同时说明,预训练不必覆盖全部下游技能,但必须把策略放到一个 downstream RL 能继续发现解的初始区域。
DM0.5 延续 VLA 架构(4B VLM 多模态主干 + 680M Action Expert),核心不是堆规模,而是四项系统增强:长历史上下文、具身推理(CoT)、动态动作对齐监督、数据质量清洗。换来的是开放环境 Zero-Shot 泛化、更长记忆、更鲁棒动作和多机型迁移,在 RoboChallenge Table30 v2 真机评测拿下 SOTA,并在 LIBERO / RoboTwin2.0 / R2R+RxR 导航基准上多项领先。
TurboVLA: Real-Time Vision-Language-Action Model at 32 Hz on an RTX 4090 with <1 GB VRAM
Hengyi Xie · Chenfei Yao · Xianjin Wu · Xuanyang Xi · Yiping Tang · Di Xu · Yingying Zhu · Dingkang Liang · Xiang Bai · Han Ding
TurboVLA 将高频控制从 LLM 居中的 V→L→A 改为轻量的直接 V+L→A,在 LIBERO 达到 97.7% 且只需 0.2B、31.2ms、0.9GB。

FM-VLA: Force-based Memory for Vision-Language-Action Models in Contact-Rich Manipulation
Ruicheng Li · Qixiu Li · Ruichun Ma · Yu Deng · Lin Luo · Zhiying Du · Jianfeng Xiang · Huizhi Liang · Ruicheng Wang · Jiaolong Yang · Baining Guo
FM-VLA 的关键不是给 VLA 再塞一种当前时刻传感器,而是把整段腕部力/力矩历史压缩成可供动作专家读取的长期事件记忆。它在找隐藏积木、精确计数按钮按压与碗内擦拭三项非马尔可夫任务上达到 83.3% 平均成功率,显著超过视觉记忆 π-MEM 的 53.7%,推理延迟仅比无记忆 π0.5 增加 3.3 ms。最值得记住的是“长时 force + 短时 state”的职责分工,但证据目前仍限于单一双臂平台和小规模任务。

LIFT 给预训练 VLA 增加一条低延迟的力觉反应通路:复制原动作专家、编码最近 6D 力历史、用零初始化交叉注意力注入,并通过在线 DAgger 覆盖策略诱导的接触分布。真机结果显示它在书本插入和河内环放置上以更少样本达到更高分数,同时大体保留视觉泛化;但收益依赖任务,仍需要人工纠正与特定硬件。

Tactile Genesis: Exploring Tactile Sensors at Scale for Learning Dexterous Tasks
Trinity Chung · Kashu Yamazaki · Dhruv Patel · Alexis Duburcq · Yiling Qiao · Katerina Fragkiadaki · Aran Nayebi
Tactile Genesis 的主要贡献不是再造一种触觉传感器,而是建立一个足够快、接口统一的虚拟实验台,让研究者第一次能在同一只手、同一任务、同一训练协议下比较触觉的类型、覆盖、分辨率与噪声。论文最值得记住的结论是:在这三项灵巧操作任务中,**覆盖手掌和近端指节通常比升级指尖传感器更重要,约 200 个整手 taxels 已经够用,而 per-taxel 六维力/力矩是最稳健的默认表示**。这是一条有价值的硬件设计先验,但证据主要来自仿真蒸馏实验;真机只验证了 XHand1 上一次策略转移,因此不能直接解读为通用硬件排行榜。

Heterogeneous Tactile Transformer
HTT 值得作为异构触觉预训练的参照:共享表征确实改善了部分感知任务,也能支持未见光学指尖上的操作策略。最有说服力的结果是无外部相机的拧玩具螺丝成功率 90%、抓豆腐 55%。但它没有证明任意新传感器即插即用,对齐也不是每个传感器、每项任务都有效。

Multisensory Continual Learning: Adapting Pretrained Visuomotor Policies to Force
Jaden Clark · Changhao Wang · Yihuai Gao · Seongheon Hong · Hojung Choi · Mark Cutkosky · Yifan Hou · Shuran Song
这篇论文最值得记住的不是“给 VLA 加一条触觉输入”,而是它把新模态接入表述成 continual learning:在少量新 contact-rich 数据上学会用 force,同时尽量不破坏旧的视觉动作能力。MuSe 的价值在于,它用 multisensory future prediction 和 replay 证明,旧任务上即使没有力标注,也能把力学结构以可迁移的方式对齐进预训练策略;真正的短板则是仍依赖离线适配和专门的 compliance 控制接口,而不是端到端解决全闭环接触控制。

STEAM: Self-Supervised Temporal Ensemble Advantage Modeling for Real-World Robot Learning
Zhihao Liu · Qiuyi Gu · Yitao Wang · Dongming Qiao · Yixian Zhang · Shuaihang Chen · Liangzhi Shi · Tianxing Zhou · Zefang Huang · Kang Chen · Zhen Guo · Quanlu Zhang · Jincheng Yu · Xiaodan Liang · Guoliang Fan · Yu Wang · Feng Gao · Xinlei Chen · Chao Yu
STEAM 值得记住的点,是它把真实机器人数据清洗问题改写成“逐帧 advantage 建模”:不用人工奖励、不用 VLM 打分,也不假设整条轨迹好坏一致,而是从专家轨迹内部的时间顺序中学习哪些 frame pair 代表推进、停滞或倒退。它尤其适合 VLA/机器人策略在真实 rollout、人工纠正和混合质量数据上继续提升:先找出真正推进任务的局部片段,再把这些片段作为 CFGRL 的高质量训练信号。

Qwen-RobotManip Technical Report: Alignment Unlocks Scale for Robotic Manipulation Foundation Models
Haoqi Yuan · Zhixuan Liang · Anzhe Chen · Ye Wang · Haoyang Li · Pei Lin · Yiyang Huang · Zixing Lei · Tong Zhang · Jiazhao Zhang · Jie Zhang · Jingyang Fan · Gengze Zhou · Qihang Peng · Chenxu Lv · Xiaoyue Chen · An Yang · Fei Huang · Junyang Lin · Dayiheng Liu · Jingren Zhou · Chenfei Wu · Xiong-Hui Chen
Qwen-RobotManip 的核心不是“再堆更多机器人数据”,而是先把不同机器人在**表示、运动和行为**三个层面拉到同一坐标系,再讨论规模化。论文最有价值的证据是:统一动作表示后,跨具身数据在 OOD 验证误差和下游成功率上才出现清晰的规模趋势;但“只用公开数据”的说法只适用于 manipulation corpus,完整训练还混入了含 proprietary data 的 VL 数据。

Geometric Action Model for Robot Policy Learning
Jisang Han · Seonghu Jeon · Jaewoo Jung · René Zurbrügg · Honggyu An · Tifanny Portela · Marco Hutter · Marc Pollefeys · Seungryong Kim · Sunghwan Hong
GAM 值得记住的不是“给 VLA 再加一个深度分支”,而是把几何基础模型本身改造成世界—动作模型:浅层编码当前多视角几何,中间因果预测未来潜状态,深层共同解码未来几何与动作。它以 1.4B 参数在 LIBERO-Plus 达到 85.5%,相机扰动达到 83.1%,推理仅 6.9 ms,说明显式几何先验可以同时改善 OOD 鲁棒性与控制效率。

T-Rex: Tactile-Reactive Dexterous Manipulation
Dantong Niu · Zhuoyang Liu · Zekai Wang · Boning Shao · Zhao-Heng Yin · Anirudh Pai · Yuvan Sharma · Stefano Saravalle · Ruijie Zheng · Jing Wang · Ryan Punamiya · Mengda Xu · Yuqi Xie · Yunfan Jiang · Letian Fu · Konstantinos Kallidromitis · Matteo Gioia · Junyi Zhang · Jiaxin Ge · Haiwen Feng · Fabio Galasso · Wei Zhan · David M. Chan · Yutong Bai · Roei Herzig · Jiahui Lei · Li Fei-Fei · Ken Goldberg · Jitendra Malik · Pieter Abbeel · Yuke Zhu · Danfei Xu · Linxi Fan · Trevor Darrell
T-Rex 的关键贡献不是把触觉当作又一种静态输入,而是让现有 VLA 的低频视觉动作规划与高频触觉修正协同工作。它用 22889 小时人类第一视角视频预训练、100 小时触觉同步机器人数据中训练和约 100 条任务示范后训练,在 12 个真实双手灵巧任务上达到 65% 平均成功率,相比最强基线 EgoScale 的 35% 高出 30 个百分点。结果很强,但目前仍是单一硬件平台上的研究级验证。

AHA-WAM: Asynchronous Horizon-Adaptive World-Action Modeling with Observation-Guided Context Routing
Jisong Cai · Long Ling · Shiwei Chu · Zhongshan Liu · Jiayue Kang · Zhixuan Liang · Wenjie Xu · Yinan Mao · Weinan Zhang · Xiaokang Yang · Ru Ying · Ran Zheng · Yao Mu
AHA-WAM 值得作为实时 WAM 的系统设计案例精读:它展示了世界模型上下文可以跨动作更新复用,并随最新观测校正。仿真平均成功率 92.80%,优化后动作更新达 24.17 Hz;更快的 Flash 达 56.95 Hz,但成功率有所下降。最重要的阅读边界是:实机另有机器人数据预训练,速度收益也包含大量工程优化。
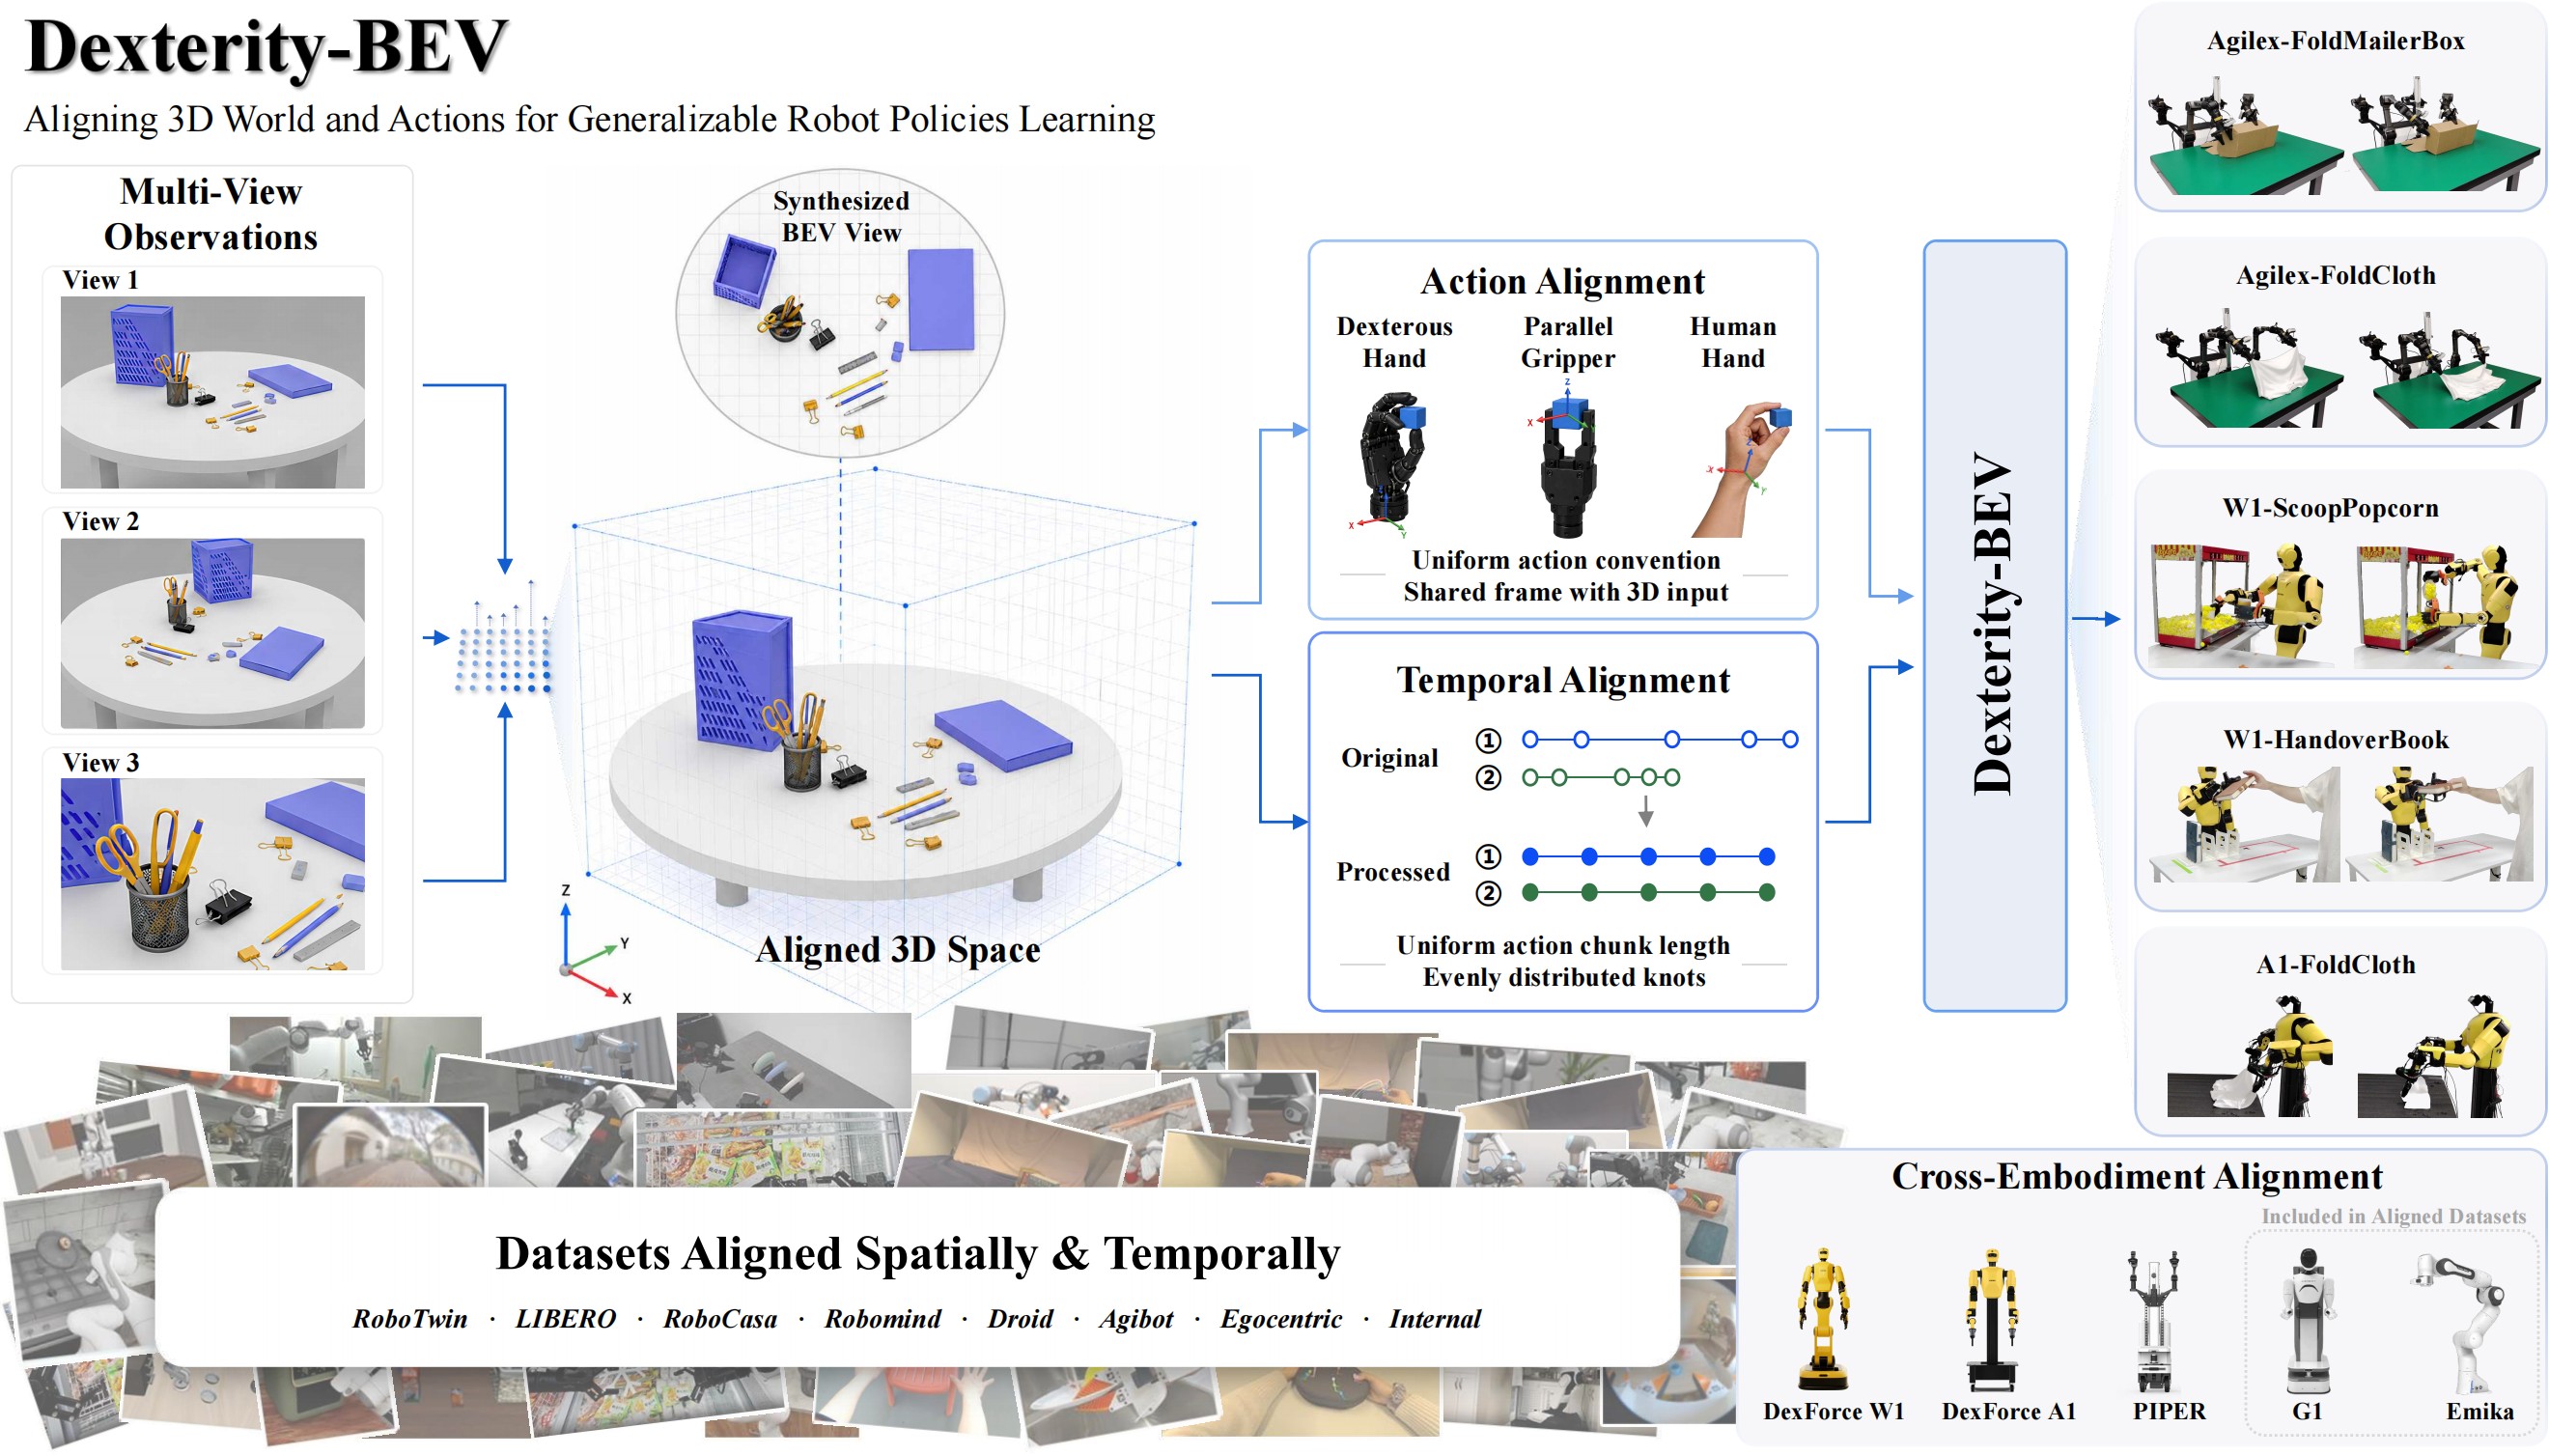
Dexterity-BEV: Aligning 3D World and Actions for Generalizable Robot Policies Learning
Huayi Zhou · Wei Gao · Dekun Lu · Ruiji Liu · Zhanqi Zhang · Ziyang Zhang · Jian Chen · Wenlve Zhou · Sheng Xu · Shumin Li · Kangyi Guo · Shichen Xu · Zixin Huang · Yongyi Su · Kui Jia
Dex-BEV 的核心不是单个新 backbone,而是一套把多视角 RGB(-D)、机器人本体状态和动作轨迹统一到 canonical Bird's-Eye-View 坐标的数据与表示工程:aligned vertex map 提供像素对齐 3D 输入,vertex spectrum 处理无深度相机,合成 BEV 图像降低视角差异,统一 TCP/SE(3) 与速度归一化对齐不同本体和遥操作轨迹。同一个 checkpoint 在 LIBERO 平均 97.8%、RoboTwin Clean 76.0%;强相机/场景扰动下仍达 89.9%,而 X-VLA 与 2D 消融均低于 10%。

Qwen-VLA: Unifying Vision-Language-Action Modeling across Tasks, Environments, and Robot Embodiments
Qwen Team
Qwen-VLA 将操作、连续导航、轨迹预测和人类第一视角运动统一为同一 action-and-trajectory prediction 问题;它不是为每个机器人另训策略,而是用 Qwen3.5-4B 与 1.15B 参数 DiT 动作专家共享建模。其关键价值是以 embodiment-aware prompt 保留各平台原生控制语义,并用四阶段训练把语言—动作先验、视觉 grounding、任务对齐和成功率优化串起来。跨操作、导航、真实 OOD 与动态零样本基准的结果表明,这个统一接口并未以明显的 specialist 性能为代价。

DexJoCo: A Benchmark and Toolkit for Task-Oriented Dexterous Manipulation on MuJoCo
Hanwen Wang · Weizhi Zhao · Xiangyu Wang · Siyuan Huang · He Lin · Boyuan Zheng · Rongtao Xu · Gang Wang · Yao Mu · He Wang · Lue Fan · Hongsheng Li · Zhaoxiang Zhang · Tieniu Tan
DexJoCo 的价值不在于提出一个新策略模型,而在于把“灵巧手到底比夹爪强在哪里、现有 VLA/模仿学习策略在哪些灵巧交互上失败”变成了可系统测量的问题。它提供 11 个功能型 MuJoCo 任务、1.1K 条人类示范、低成本手套遥操作采集系统,以及面向视觉随机化、动力学随机化、多任务训练和 action-head 适配的评测工具链。对后续灵巧手机器人学习来说,这篇更像基础设施论文:它给出了一个比 pick-and-place 更接近真实灵巧操作的压力测试场。

AttenA+: Rectifying Action Inequality in Robotic Foundation Models
Daojie Peng · Fulong Ma · Jiahang Cao · Qiang Zhang · Xupeng Xie · Jian Guo · Ping Luo · Andrew F. Luo · Boyu Zhou · Jun Ma
AttenA+ 的核心价值是指出 VLA/WAM 训练里一个很朴素但长期被忽略的问题:机器人动作时间步并不等价,慢速精细动作往往比快速过渡动作更决定任务成败。它用速度场给低速关键动作更高 loss 权重,不改模型结构、不加参数,却能在 Libero、RoboTwin 2.0 和真实 Franka 任务上稳定抬高强基线的上限。值得记住的不是某个复杂网络,而是“动作序列的物理结构可以直接进入训练目标”。

ForceFlow: Learning to Feel and Act via Contact-Driven Flow Matching
Shuoheng Zhang · Yifu Yuan · Hongyao Tang · Yan Zheng · Qiaojun Yu · Pengyi Li · Guowei Huang · Helong Huang · Xingyue Quan · Jianye Hao
ForceFlow 的关键不是简单给模仿策略多拼一组力信号,而是让十步力历史通过 AdaLN 在每个生成层持续调制动作,同时让视觉只通过 cross-attention 提供按需空间参考,再用“动作 + 下一步六维力”联合预测形成隐式柔顺正则。六项真机任务平均成功率为 81.67%,较输入模态相同的 ForceVLA 45% 高 36.67 个百分点;但它仍依赖高质量六轴力矩传感器、手工标注的 VLM 接触点数据与单一 xArm6 平台,不能直接外推成低成本通用接触策略。

RL Token: Bootstrapping Online RL with Vision-Language-Action Models
Charles Xu · Jost Tobias Springenberg · Michael Equi · Ali Amin · Adnan Esmail · Sergey Levine · Liyiming Ke
这篇工作最重要的点,是给 VLA 和在线 RL 之间找到了一个足够轻量的接口。作者没有直接对整套大模型做昂贵 RL,而是让预训练 VLA 暴露一个紧凑的 `RL token`,再在这个表示上训练小型 actor-critic,从而把 VLA 的泛化能力和 real-world online RL 的样本效率拼接起来。

π0.7: a Steerable Generalist Robotic Foundation Model with Emergent Capabilities
Bo Ai · Ali Amin · Raichelle Aniceto · Ashwin Balakrishna · Greg Balke · Kevin Black · George Bokinsky · Shihao Cao · Thomas Charbonnier · Vedant Choudhary · Foster Collins · Ken Conley · Grace Connors · James Darpinian · Karan Dhabalia · Maitrayee Dhaka · Jared DiCarlo · Danny Driess · Michael Equi · Adnan Esmail · Yunhao Fang · Chelsea Finn · Catherine Glossop · Thomas Godden · Ivan Goryachev · Lachlan Groom · Haroun Habeeb · Hunter Hancock · Karol Hausman · Gashon Hussein · Victor Hwang · Brian Ichter · Connor Jacobsen · Szymon Jakubczak · Rowan Jen · Tim Jones · Gregg Kammerer · Ben Katz · Liyiming Ke · Mairbek Khadikov · Chandra Kuchi · Marinda Lamb · Devin LeBlanc · Brendon LeCount · Sergey Levine · Xinyu Li · Adrian Li-Bell · Vladislav Lialin · Zhonglin Liang · Wallace Lim · Yao Lu · Enyu Luo · Vishnu Mano · Nandan Marwaha · Aikys Mongush · Liam Murphy · Suraj Nair · Tyler Patterson · Karl Pertsch · Allen Z. Ren · Gavin Schelske · Charvi Sharma · Baifeng Shi · Lucy Xiaoyang Shi · Laura Smith · Jost Tobias Springenberg · Kyle Stachowicz · Will Stoeckle · Jiaming Tang · Jimmy Tanner · Shalom Tekeste · Marcel Torne · Kyle Vedder · Quan Vuong · Anna Walling · Haohuan Wang · Jason Wang · XuDong Wang · Chris Whalen · Samuel Whitmore · Blake Williams · Charles Xu · Sukwon Yoo · Lili Yu · Wuming Zhang · Zhuoyang Zhang · Ury Zhilinsky
π0.7 的关键价值不只是把模型继续做大,而是把“可控的通才机器人策略”往前推了一步。它试图解决的核心问题是:当训练数据越来越杂时,机器人基础模型怎样既能吃下示范、失败轨迹、人类视频和网页数据,又不在推理时退化成平均化、含糊的动作。作者给出的答案是把“怎么做”也写进 prompt,包括子任务语言、子目标图像、质量/速度/错误等 episode metadata,让模型学会在多模态上下文里被 steer。

MEM: Multi-Scale Embodied Memory for Vision Language Action Models
Marcel Torne · Karl Pertsch · Homer Walke · Kyle Vedder · Suraj Nair · Brian Ichter · Allen Z. Ren · Haohuan Wang · Jiaming Tang · Kyle Stachowicz · Karan Dhabalia · Michael Equi · Quan Vuong · Jost Tobias Springenberg · Sergey Levine · Chelsea Finn · Danny Driess
这篇工作的重点,是把机器人策略里的“记忆”从单一历史帧堆叠,升级成多尺度、多模态的长期记忆结构。MEM 用视频短期记忆处理最近视觉细节,用文本长期记忆保留高层语义进度,从而把 VLA 推到更长时间跨度的任务上。

RISE: Self-Improving Robot Policy with Compositional World Model
Jiazhi Yang · Kunyang Lin · Jinwei Li · Wencong Zhang · Tianwei Lin · Longyan Wu · Zhizhong Su · Hao Zhao · Ya-Qin Zhang · Li Chen · Ping Luo · Xiangyu Yue · Hongyang Li
RISE 把真实机器人在线 RL 的瓶颈从物理世界移到想象空间:它不让机器人反复试错,而是用一个动作条件化的多视角视频 dynamics model 合成未来状态,再用进度回归与 TD learning 联合训练的 value model 为动作块计算 advantage,最后用这个 advantage 条件化并更新 π0.5 VLA。三项真机任务上,RISE 分别把动态砖块分拣、背包整理和纸箱关闭成功率提升到 85%、85% 和 95%,显著超过 PPO、DSRL、DAgger 和 RECAP。核心代价也很明确:视觉世界模型预训练和微调需要大量 H100 计算,而且结果仍受世界模型覆盖与物理一致性的上限约束。

DexImit: Learning Bimanual Dexterous Manipulation from Monocular Human Videos
Juncheng Mu · Sizhe Yang · Yiming Bao · Hojin Bae · Tianming Wei · Linning Xu · Boyi Li · Huazhe Xu · Jiangmiao Pang
DexImit 的价值在于把大量单目人类操作视频转成可训练的双手灵巧机器人数据,而不是直接把 human embodiment 当成 policy 输入。它通过重建、调度、动作生成和增强四阶段,把 Internet 或生成模型产生的人类视频变成物理可行的机器人轨迹,并在零真实机器人数据下支持 sim-to-real 部署。

Action-to-Action Flow Matching
Jindou Jia · Gen Li · Xiangyu Chen · Tuo An · Yuxuan Hu · Jingliang Li · Xinying Guo · Jianfei Yang
这篇论文值得记住,因为它重新审视了机器人扩散策略的起点:机器人已经有连续的本体反馈,就不必每次从无信息的高斯噪声开始生成动作。A2A 用已执行动作的历史序列初始化未来动作的 flow matching,在保持生成策略多模态与泛化能力的同时,把推理压到单步 0.56 ms。它的真正价值不是又一个更快的采样器,而是把控制策略的生成先验从“随机噪声”改成“机器人自身的动力学历史”。

FD-VLA: Force-Distilled Vision-Language-Action Model for Contact-Rich Manipulation
Ruiteng Zhao · Wenshuo Wang · Yicheng Ma · Xiaocong Li · Francis E.H. Tay · Marcelo H. Ang Jr. · Haiyue Zhu
FD-VLA 用真实力信号做训练期教师,让一个由视觉与机器人本体状态条件化的可学习 query 预测潜在力 token;部署时不再需要力传感器,却在三项真实接触操作上达到 61.1% 平均成功率。真正值得记住的不是“无传感器也能估力”,而是把含噪物理模态蒸馏为任务相关中间表示,并用定向注意力保护冻结 VLM 的视觉—语言语义。证据仍局限于单台 UR5e、三项任务和 50 条示范/任务,尚不能视为通用触觉替代方案。

Action-Sketcher: From Reasoning to Action via Visual Sketches for Long-Horizon Robotic Manipulation
Huajie Tan · Peterson Co · Yijie Xu · Shanghang Zhang
Action-Sketcher 将语言推理显式化为点、框、箭头组成的可编辑视觉草图,并以 See-Think-Sketch-Act 事件循环连接长时域规划与机器人动作。

Emergence of Human to Robot Transfer in Vision-Language-Action Models
Simar Kareer · Karl Pertsch · James Darpinian · Judy Hoffman · Danfei Xu · Sergey Levine · Chelsea Finn · Suraj Nair
这篇论文的关键判断是:`human-to-robot transfer` 不是简单靠对齐技巧手工做出来的,而是会随着 VLA 预训练规模和多样性增长而“涌现”。也就是说,当机器人预训练覆盖足够多任务、场景和 embodiment 后,模型开始能够真正从 human video 中学到对机器人有用的东西。

Spatial Forcing: Implicit Spatial Representation Alignment for Vision-language-action Model
Fuhao Li · Wenxuan Song · Han Zhao · Jingbo Wang · Pengxiang Ding · Donglin Wang · Long Zeng · Haoang Li
Spatial Forcing 用 VGGT 的多视角空间 latent 监督 VLA 中间层视觉 token,推理阶段不增结构,在 LIBERO 达到 98.5% 并带来 3.8× 训练效率提升。
ManipForce: Force-Guided Policy Learning with Frequency-Aware Representation for Contact-Rich Manipulation
Geonhyup Lee · Yeongjin Lee · Kangmin Kim · Seongju Lee · Sangjun Noh · Seunghyeok Back · Kyoobin Lee
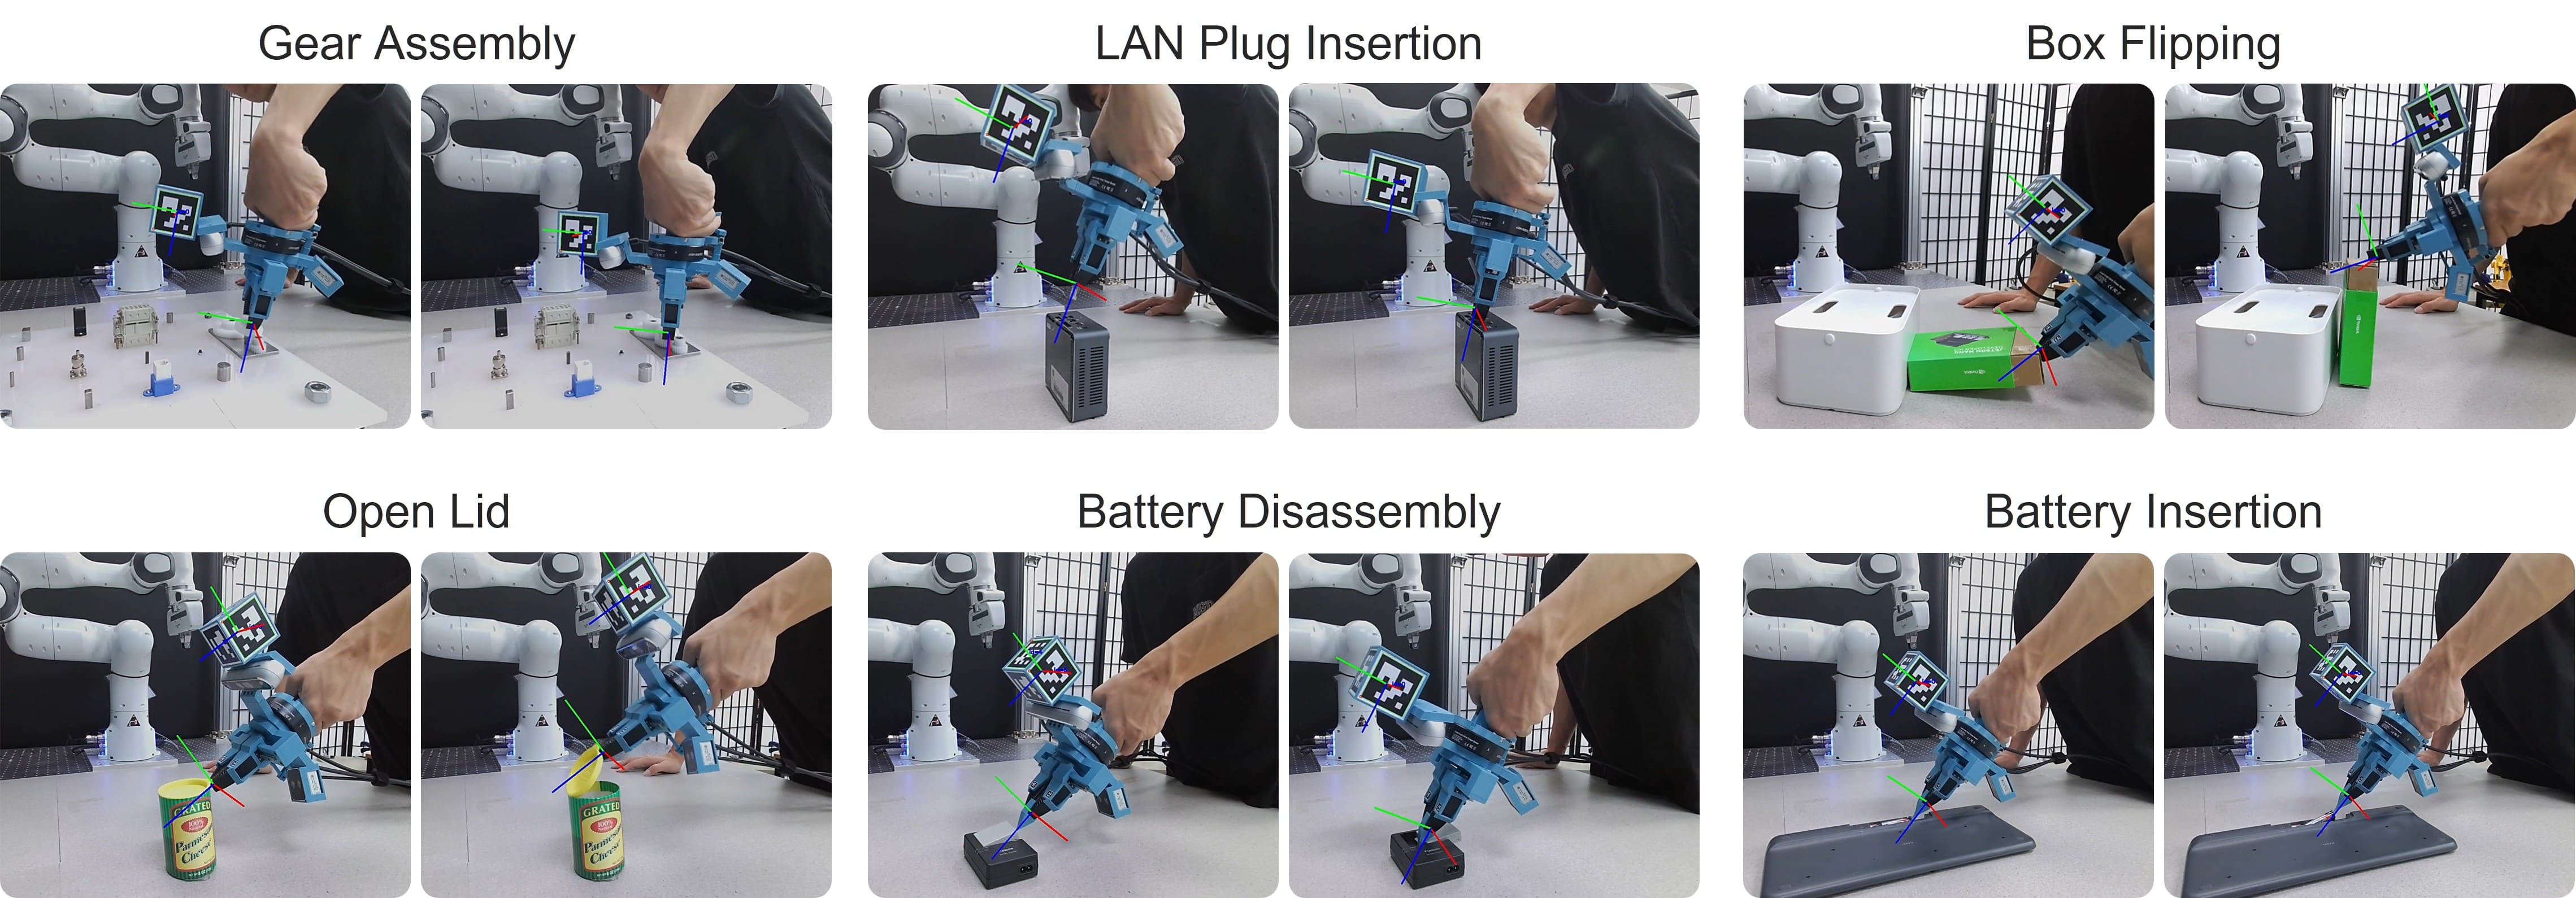
ManipForce 的价值在于把“接触示教怎么采”和“高频力觉怎么进策略”合成了一条闭环:手持系统用双目手眼 RGB、外部 3D ArUco 跟踪和腕部 AIDIN AFT200 六维 F/T 传感器记录自然人手示教,F/T 达 200Hz、RGB 和位姿为 30Hz;策略侧的 FMT 不把力信号降采样成图像帧的附属输入,而是用频率感知时间嵌入、模态嵌入和双向交叉注意力,把异步视觉 token 与力 token 融入 Transformer Diffusion Policy。六个真机任务上,FMT 平均成功率 83%,DINOv2-B 版 RGB-only Transformer DP 为 22%;最难的电池拆装/插入仍只有 65%/60%,说明力觉没有消除接触任务的全部不确定性。齿轮装配的 F/T 采样从 30Hz 提到 200Hz 时成功率 40%→95%,是论文最直接的频率证据。

TA-VLA: Elucidating the Design Space of Torque-aware Vision-Language-Action Models
Zongzheng Zhang · Haobo Xu · Zhuo Yang · Chenghao Yue · Zehao Lin · Huan-ang Gao · Ziwei Wang · Hao Zhao
TA-VLA 不是只提出一种新网络,而是系统回答力矩应该怎样进入预训练 VLA:关节力矩应接到动作解码器而非视觉语言编码器;一段力矩历史应先聚合成一个 token,而不是逐帧占用多个 token;训练时还应让模型联合预测未来动作与未来力矩。三项设计叠加后,π0 在五项接触密集任务上的总成功率从 23/100 提升到 86/100,在五项普通操作上仍从 85% 小幅升到 89%。证据说明廉价电机电流推算的关节力矩确实能补足视觉,但它不是经标定的末端接触力,跨机器人证据也仍很有限。

FoAR: Force-Aware Reactive Policy for Contact-Rich Robotic Manipulation
Zihao He · Hongjie Fang · Jingjing Chen · Hao-Shu Fang · Cewu Lu
FoAR 的关键不是把力/扭矩简单拼到视觉策略上,而是先预测未来是否会接触,再用这个概率门控力觉特征,并在部署时用力觉触发小步反应式修正。仅用 50 条示范,它在擦除、削皮和切菜等接触丰富任务上显著超过 RISE 与多种融合基线,并在白板被移动或重写后保持 100% 基本动作成功率。

Reactive Diffusion Policy: Slow-Fast Visual-Tactile Policy Learning for Contact-Rich Manipulation
Han Xue · Jieji Ren · Wendi Chen · Gu Zhang · Yuan Fang · Guoying Gu · Huazhe Xu · Cewu Lu
RDP 的关键不是“把力塞进 Diffusion Policy”,而是把力放到正确的时间尺度和网络位置:低频 latent diffusion policy 负责生成约 0.67 秒的高层动作块,快速 asymmetric tokenizer 则以 24 FPS 读取最新触觉或六维 wrench,把潜在动作解码成末端相对位姿。模型不输出目标力、阻抗或力矩,学到的是“看到这种受力与任务阶段时,位置应该再压入、退出还是沿曲面移动一点”。 这正面回应“小位移很难学、策略浮在表面”的问题。论文观察到有效修正确实只有亚毫米级:削皮器受力突增时向上卸力,接近黄瓜末端时向下压入以继续贴面,双臂夹杯接触后向外修正以免压瘪。真正决定能否学到的不是位移绝对值,而是示范中是否有稳定的“力变化—微位移—接触结果”相关性,以及训练、推理和机器人执行是否在时间上对齐。

ForceMimic: Force-Centric Imitation Learning with Force-Motion Capture System for Contact-Rich Manipulation
Wenhai Liu · Junbo Wang · Yiming Wang · Weiming Wang · Cewu Lu
ForceMimic 解决的不是“给机器人加一颗力传感器”,而是先用一个约 50 美元的手持 ForceCapture 在没有机器人的情况下采集自然的人类力—位交互,再把示范转成伪机器人数据;HybridIL 用扩散策略同时预测位姿和 wrench,并在执行时按力阈值切换正交混合力位控制。西葫芦削皮实验中,它的动作正确率为 100%、连续削皮超过 10 cm 的成功率为 85%,优于 Raw DP 的 80%/55%。

Adaptive Compliance Policy: Learning Approximate Compliance for Diffusion Guided Control
Yifan Hou · Zeyi Liu · Cheng Chi · Eric Cousineau · Naveen Kuppuswamy · Siyuan Feng · Benjamin Burchfiel · Shuran Song
ACP 把柔顺性从低层控制器里的固定超参数提升为策略需要预测的动作变量:它从单条人体示范近似标注空间与时间变化的刚度方向和幅值,再由扩散策略结合视觉、位姿和力反馈生成。真实机器人翻转与花瓶擦拭分别达到 96% 和 93.75% 总成功率,显著超过固定柔顺和刚性位置策略。最值得记住的是它把接触约束转成可学习标签,但结论依赖慢速、轻物体、非夹持接触等明确假设。

TacDiffusion: Force-domain Diffusion Policy for Precise Tactile Manipulation
Yansong Wu · Zongxie Chen · Fan Wu · Lingyun Chen · Liding Zhang · Zhenshan Bing · Abdalla Swikir · Sami Haddadin · Alois Knoll
TacDiffusion 把扩散策略从常见的位姿/关节动作域移到六维力域:模型根据外部 wrench、内部 wrench 和末端速度生成前馈 wrench,动态系统滤波器再把 50–500 Hz 的模型输出平滑升频到 1 kHz,交给阻抗控制器执行。最佳的 DF3 在四种未见几何上的平均成功率为 95.7%,高于行为树专家基线的 83.3%;但更大的 DF4 虽然离线损失最低,却因只有 51.2 Hz 的推理频率而显著退化。这篇论文最强的结论不是“模型越大越好”,而是力策略的预测质量必须与控制带宽一起优化。
OpenVLA: An Open-Source Vision-Language-Action Model
Ted Xiao · Ashwin Balakrishna · Suraj Nair · Rafael Rafailov · Ethan Foster · Pannag Sanketi · Quan Vuong · Thomas Kollar · Benjamin Burchfiel · Russ Tedrake · Dorsa Sadigh · Sergey Levine · Percy Liang · Chelsea Finn
OpenVLA 的价值不只是开源一个 VLA 模型,而是把可训练、可微调、可部署的完整开源机器人大模型工作流真正落到了实践层面。

Causal Confusion in Imitation Learning
Pim de Haan · Dinesh Jayaraman · Sergey Levine
这篇 NeurIPS 2019 论文值得作为模仿学习和历史记忆设计的基础阅读:更多观测可能让策略更容易找到专家数据里的捷径,因此离线预测改进并不保证闭环控制改进。作者把这种失效称为因果误识别,并证明少量有针对性的交互可以在受控基准上修复它。论文的重要价值是诊断框架和干预思路;它没有验证面向真实驾驶或现代大规模 VLA 的通用解决方案。
最近材料
2026-10-22
Humanoid Mobility via Attention-based Contacts
值得记住的是“保留示范中的接触结构,释放连接接触的全身运动”这一接口设计。它让单个 G1 策略在部署时摆脱参考轨迹,同时支持手、肘、膝等多部位协同。八个复合课程的仿真平均成功率达到 92.5%,但本文还没有证明开放三维场景中的通用移动或可认证的实机可靠性。
打开阅读