Dexterity-BEV: Aligning 3D World and Actions for Generalizable Robot Policies Learning
Dexterity-BEV: Aligning 3D World and Actions for Generalizable Robot Policies Learning
Huayi Zhou · Wei Gao · Dekun Lu · Ruiji Liu · Zhanqi Zhang · Ziyang Zhang · Jian Chen · Wenlve Zhou 等
一句话结论
Dex-BEV 的核心不是单个新 backbone,而是一套把多视角 RGB(-D)、机器人本体状态和动作轨迹统一到 canonical Bird's-Eye-View 坐标的数据与表示工程:aligned vertex map 提供像素对齐 3D 输入,vertex spectrum 处理无深度相机,合成 BEV 图像降低视角差异,统一 TCP/SE(3) 与速度归一化对齐不同本体和遥操作轨迹。同一个 checkpoint 在 LIBERO 平均 97.8%、RoboTwin Clean 76.0%;强相机/场景扰动下仍达 89.9%,而 X-VLA 与 2D 消融均低于 10%。
关键词
摘要
中文摘要
端到端操作策略结合网页规模预训练 VLM,显示出通用灵巧机器人操作的潜力,但继承了 2D 基础模型的两个限制:依赖 2D RGB 输入而忽略操作的内在三维性;输入输出空间以及不同机器人本体、相机配置和轨迹数据集之间缺乏空间 3D 对齐。本文提出一系列贡献:首先引入 aligned vertex map 与 vertex spectrum,用相机标定和可选深度将像素级 3D 表示接入 2D 视觉输入,使 3D 感知与 2D 大 VLM 的泛化相结合。其次,将各相机像素级 3D 信息和机器人动作表达到共享坐标,对齐策略输入输出;进一步指定 canonical BEV 对齐帧并构造 BEV 图像,得到对相机姿态变化更稳健的视角不变表示。为了支持规模训练与评测,论文还建立完整数据处理管线,并跨不同机器人、人类操作者和数据集进行轨迹时间对齐。
英文摘要
End-to-end manipulation policies, combined with web-scale pretrained Vision-Language Models (VLMs), show the promise for generalizable and dexterous robotic manipulation. However, they inherit two key limitations from 2D foundation models: 1) the reliance on 2D RGB inputs that ignores the intrinsically 3D nature of manipulation; and 2) the lack of spatial 3D alignment between input-output spaces as well as across diverse robot embodiments, camera setups, and trajectory datasets. In this paper, we present a series of contributions to address these issues. First, we introduce aligned vertex map and vertex spectrum — a pixel-wise 3D representation that elevates 2D visual inputs to 3D, using camera calibration and optional depth. This novel input representation marries 3D awareness with the generalization of 2D large VLMs. Then, we propose to align the inputs and outputs of manipulation policies by expressing per-pixel 3D information of each camera view and robot actions to a shared coordinate. Based on this, we designate a canonical Bird's-Eye-View (BEV) alignment frame and innovatively propose to construct BEV images, producing a view-invariant representation robust to camera pose variations. To enable training and evaluation at scale, we develop a comprehensive data processing pipeline to perform such alignments; we also introduce a novel temporal alignment scheme for trajectories across diverse robots, human operators, and datasets.
直观理解
如果把不同机器人和相机的数据直接混合,模型看到的是“左臂基坐标系里的末端位姿”“右臂基坐标系里的末端位姿”“某个第三视角 RGB”这些彼此不可比的对象。Dex-BEV 先为桌面操作指定一个共享 BEV 坐标,把每个像素反投影或用候选深度投影到该坐标,再把夹爪 TCP 和未来动作也写成该坐标里的 SE(3)。同时,它把多视角点云俯视栅格化成一张 BEV 图:相机怎么摆,物体在俯视图中的位置仍基本不变,模型因此不必记住“当前视角长什么样”。
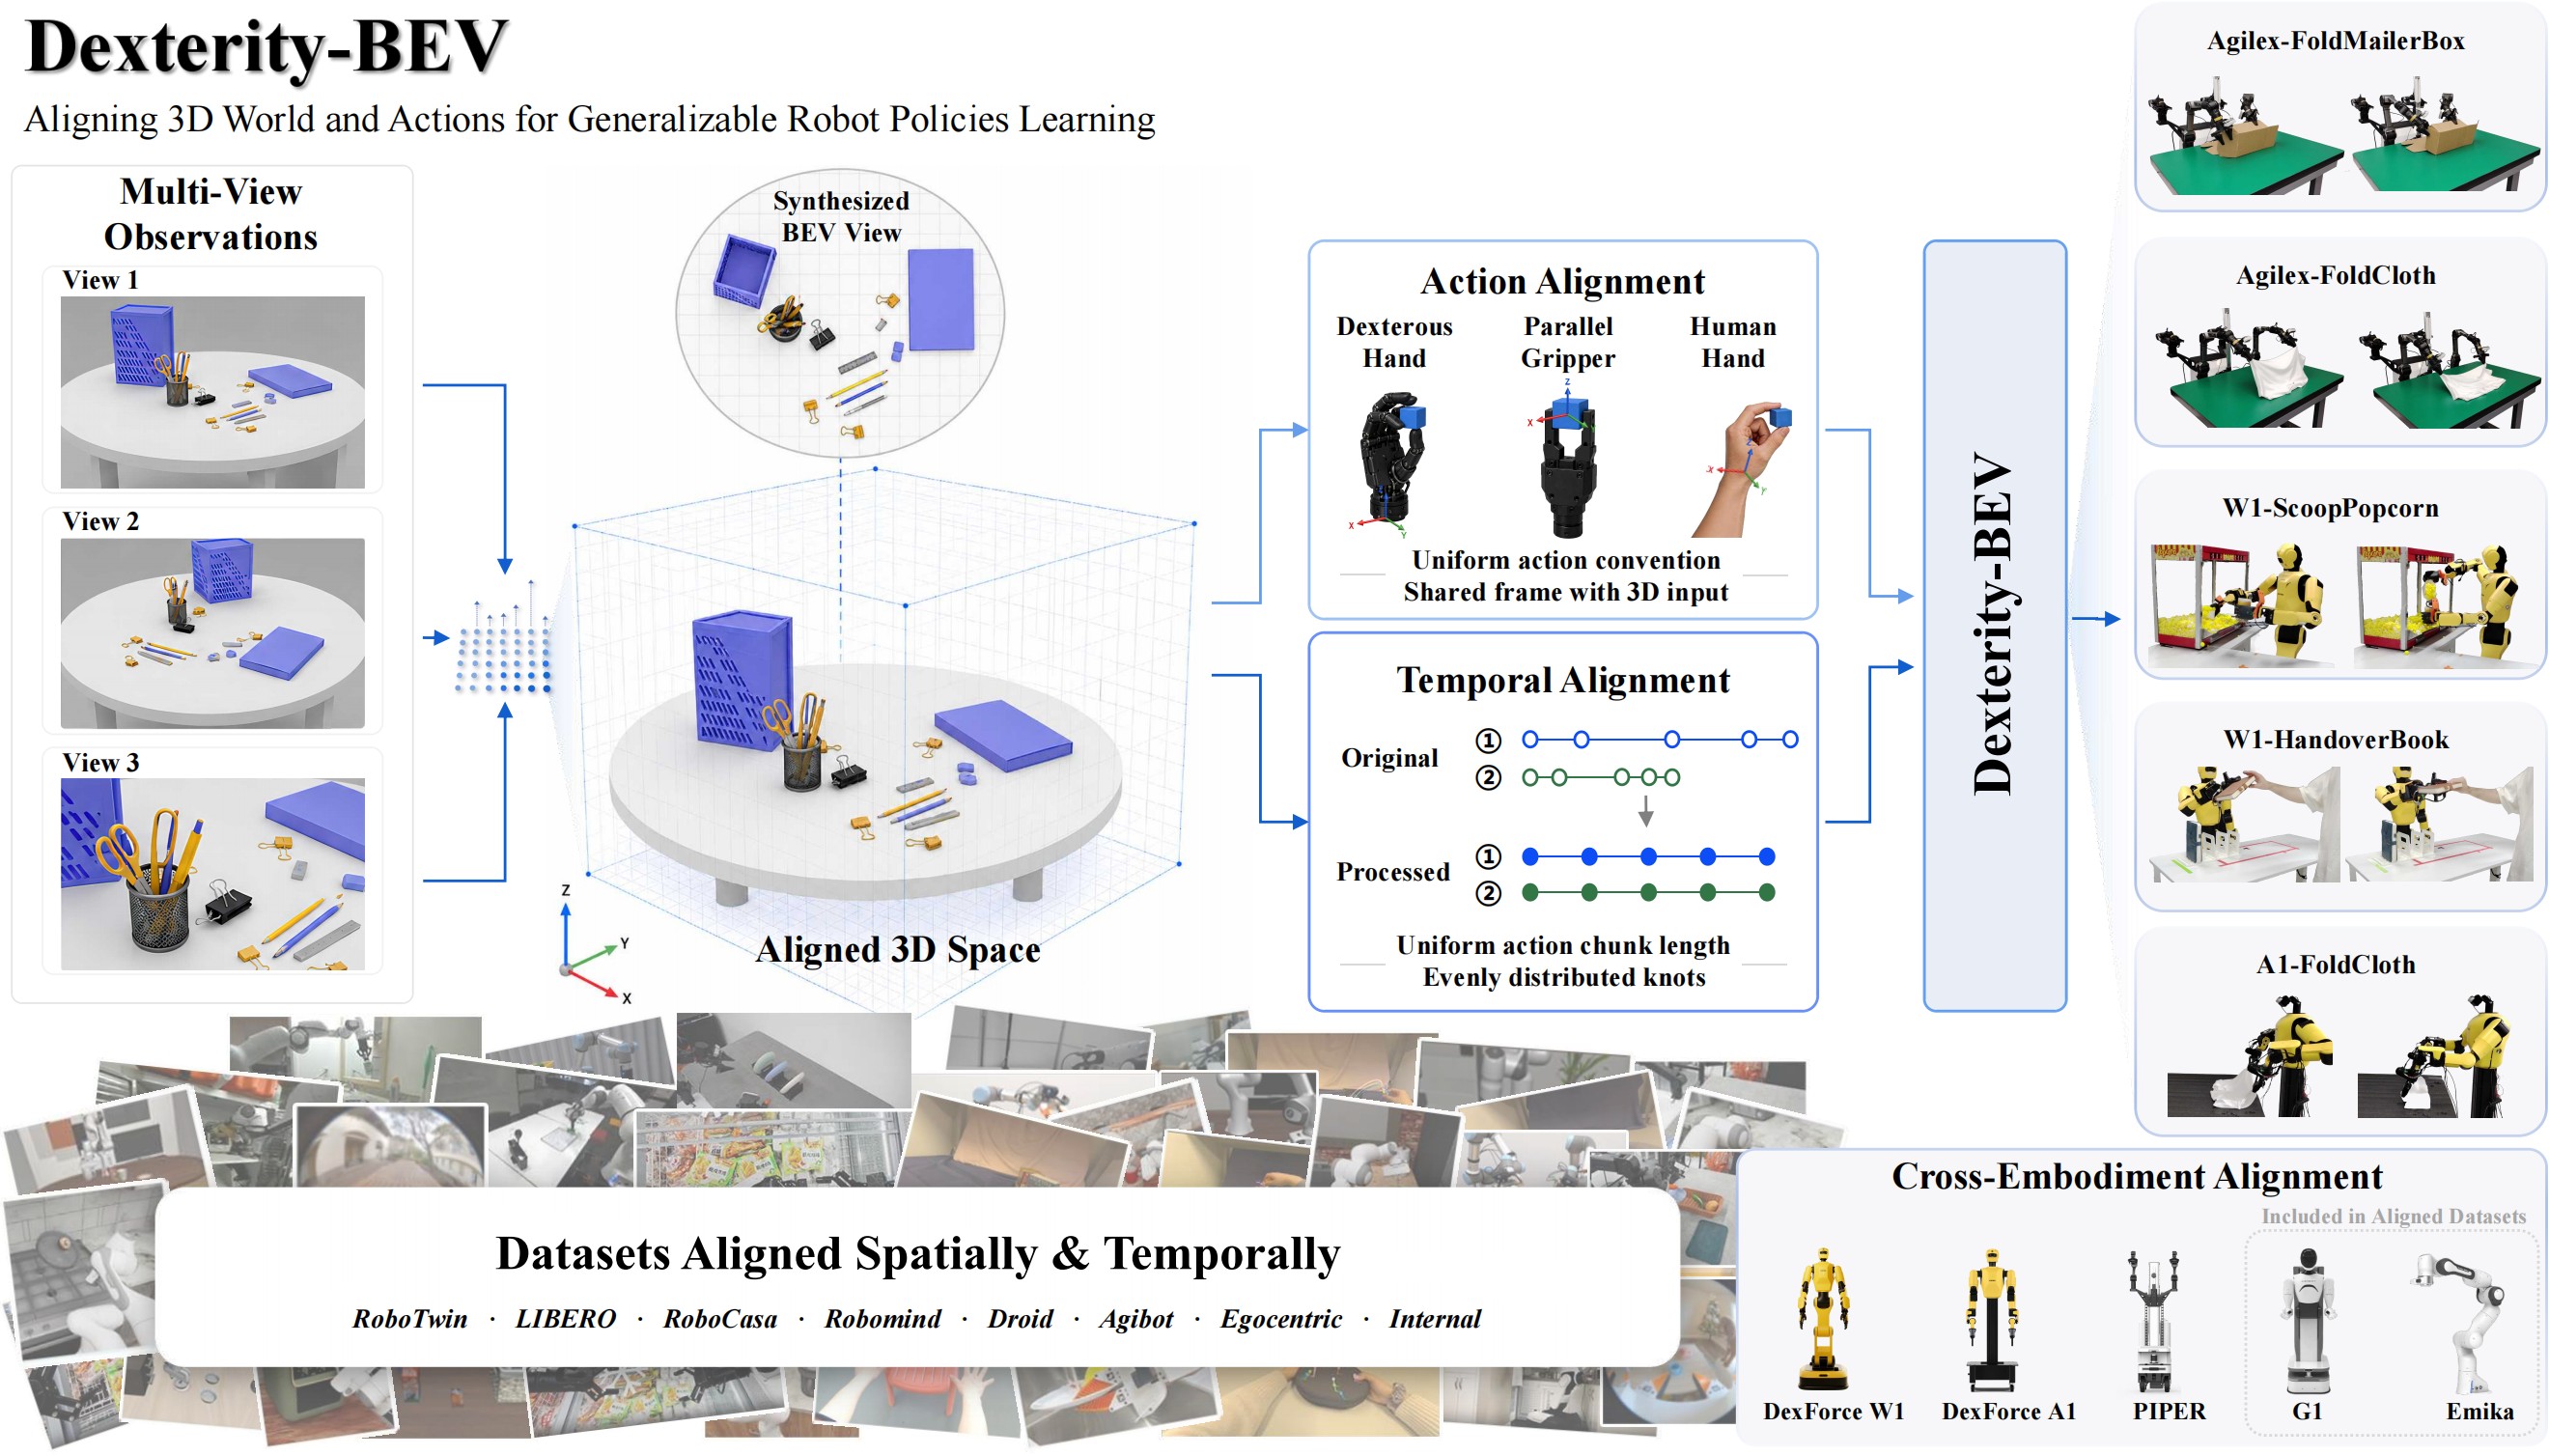
多视角观测、BEV 图像、动作表示和异构数据在统一 3D 空间中对齐。
背景与问题
为什么做
预训练 VLM/VLA 的优势来自大规模 2D 图像与语言,但机器人操作本身是 3D 的:抓取点、双臂相对位姿、桌面布局和夹爪可达范围都依赖相机外参、深度和统一坐标系。纯点云/体素路线虽然显式三维,却难以享受 2D foundation model 的数据规模;直接把 RGB、关节角或末端位姿拼起来,又会让同一物理任务在不同相机和本体下呈现为完全不同的输入输出分布。
问题缺口
现有工作往往只解决其中一层:3D 输入提升感知,action representation 提升跨本体,数据工具链处理各自数据集,但缺少一个同时约束观测、动作、时间与异构数据集的部署级管线。Dex-BEV 要回答的是:如何在不放弃 2D VLM 泛化的前提下,让输入和输出共享一个明确、可跨平台计算的 3D 空间。
方法
方法概述
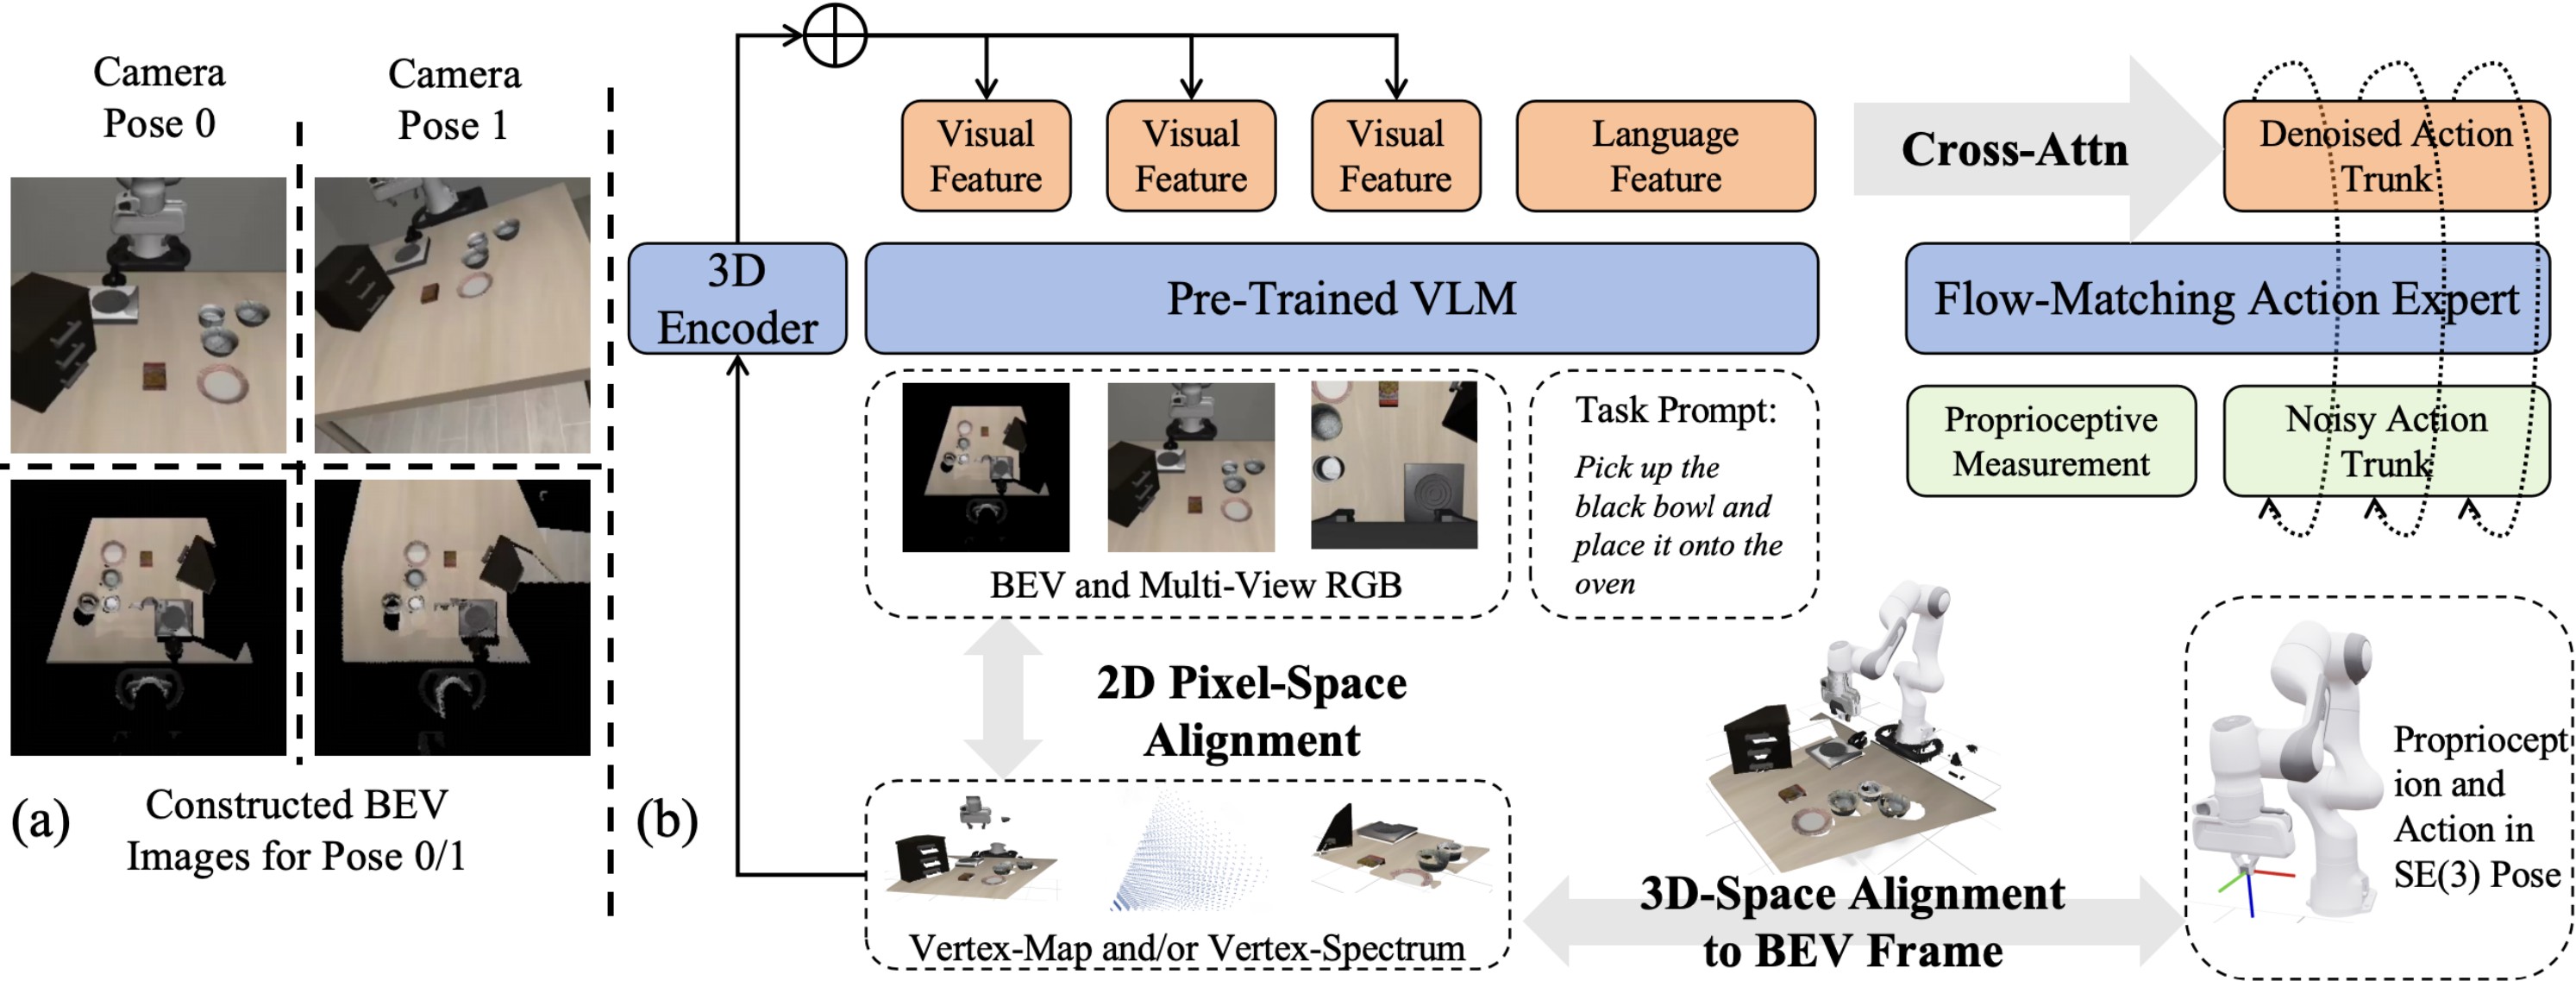
Dex-BEV 保留 VLM + flow-matching action expert 的策略结构,但在进入模型前完成三层对齐:空间上把多视角像素、本体状态和动作变换到 canonical BEV/SE(3) 空间;表示上同时提供原始 RGB、像素对齐 vertex map/vertex spectrum 和俯视 BEV 图;时间上按标准线速度/角速度重参数化轨迹,再用三次样条得到统一动作块。
核心机制
aligned vertex map 保持图像 patch 结构,却把每个像素的几何值从局部相机坐标变换到共享坐标,使同一物理点跨视角取值一致;BEV 图把聚合彩色点云在 1.5 m ROI 内栅格化为 224×224 的俯视 RGB 与高度/vertex map,显著降低相机姿态引起的输入变化;动作侧统一 TCP convention 并用共享帧 SE(3) 表示本体状态与输出,使策略学习目标不再随机器人基座定义漂移。
方法拆解
- 像素级 3D 输入:有深度时,用
D K^-1 [u,v,1]反投影成 camera vertex map,再经外参变换到共享 BEV 帧;该 map 仍与 RGB patch 对齐,能直接加入 2D VLM。 - 无深度候选谱:对 RGB-only 视角,用 linear-increasing discretization 在工作深度范围内采样候选深度,将每个 pixel-depth pair 投到 BEV 帧形成
M×3coordinate grid,再由轻量编码器转为位置嵌入。 - canonical BEV 帧:桌面场景以 3D ROI 底部中心为原点,其他场景可用机器人基座;BEV 图以 z 轴为俯视方向,聚合多视角彩色点云并生成像素对齐高度/vertex map。
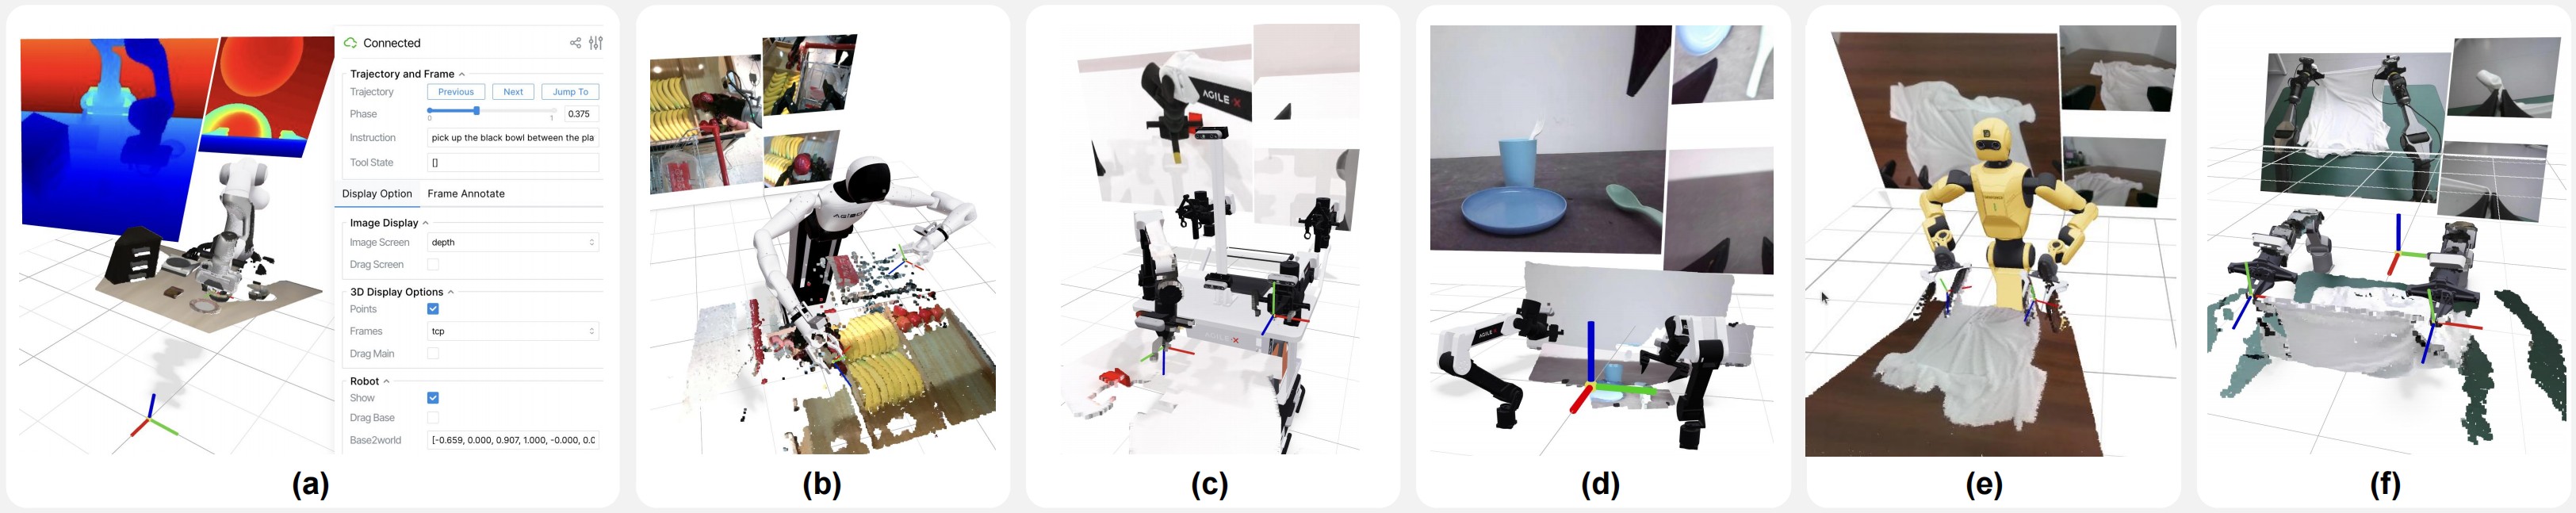
- 异构数据处理:用手工 GUI、ICP、DepthAnything V3、FoundationStereo、仿真 replay 与 URDF 注册补齐/统一相机内外参和机器人几何;公共数据包括 RoboTwin、LIBERO、RoboCasa、RoboMIND、Droid、AgiBot、egocentric 与内部数据。
- 动作与 TCP 对齐:parallel-jaw 锚定在 jaw tip,多指手锚定在 wrist;通过统一 URDF/forward kinematics 计算各平台绝对 SE(3) pose,避免左右臂基座不一致造成的伪差异。
- 时间对齐:由相邻末端平移和四元数旋转角计算标准速度下的
Δτ=max(ΔL/vstd, Δθ/ωstd),双臂取最大值;近似静态帧保留或删除,再用 cubic spline 插值统一 chunk。
关键要点
- Dex-BEV 的 3D 性来自“坐标约定 + 数据管线”,不是单纯给模型增加深度通道。
- BEV 图像把视角不变性显式化,仍保留原始多视角图像,让模型同时看到自然观测与规范几何视图。
- temporal alignment 把“同样动作但快慢不同”的伪分布差异归一化,前提是任务近似 quasi-static;抛掷等强动力学任务不适用。
结果
结果速览表
| 问题 | 最直接证据 | 边界 |
|---|---|---|
| 跨本体是否有效? | 同一 checkpoint:LIBERO 97.8%、RoboTwin Clean 76.0% | RoboTwin Randomized 42.0% 仍低 |
| 抗相机/布局扰动? | Modified LIBERO 89.9%;2D 基线 `<10%` | 需相机标定与可达性补偿 |
| 真实灵巧任务是否提升? | 5 任务 76.7–96.7%,均高于 π0/X-VLA | 每任务 30 次,平台相关 |
| 无深度怎么办? | vertex spectrum 候选深度位置嵌入 | 固定量化,细接触边界可能失真 |
| 是否预测世界? | 不输出未来 BEV/点云 | 未来工作提出扩展为 3D WAM |
洞察
风险与判断
局限
- 强依赖相机外参精度:振动、热变形、碰撞和外参漂移会造成 BEV 图与 vertex map 的几何畸变;作者明确将其列为方法学限制。
- 无深度深度候选有量化误差:LID 固定候选深度在细粒度灵巧操作中可能损失亚厘米几何边界。
- 短历史窗口限制长任务抽象:当前策略难以维持与即时几何变化无关的长时序语义进度。
- 真实评测仍有硬件与 OOD 瓶颈:机械磨损、关节 backlash、固定基座可达性、极端材料、强光照变化和反射桌面都会导致失败。
- 可复现元数据需谨慎:用户提供的项目 PDF 与项目页一致列出 arXiv:2606.02274,但本机当时无法访问 arXiv abs 页;日期按公开索引与项目 BibTeX 采用 2026-06-01,后续应再核对版本历史。
适用场景
- 相机可标定、桌面 ROI 可定义的双臂/多视角操作,需要跨相机位姿和场景布局复用策略。
- 需要把多个机器人、平行爪、多指手、人类遥操作轨迹混合训练的数据工程场景。
- 希望保留 2D VLM 预训练权重,同时显式注入 3D 空间与动作坐标的 VLA/WAM 系统。
最终判断
- 这是 3D-native 具身模型专题中的“数据/坐标基础设施”起点。Dex-BEV 证明了观测-动作-时间三重对齐能显著提升跨本体与抗视角扰动能力,modified LIBERO 的
<10% → 89.9%是最强证据。 - 它更像 policy interface,而不是完整世界模型:模型不预测未来 BEV/点云状态,未来方向正是与 WAM 集成。
- 生产部署前必须验证标定鲁棒性:校准误差、外参漂移和固定深度候选量化是否会在目标平台上抵消对齐收益,比再刷基准成功率更关键。
相关主题
3D-Native Embodied Model
收集把具身模型的观测、动作、世界状态和异构数据统一到显式 3D 空间的路线,比较 BEV、点流、体素、SE(3) 动作空间与世界预测接口的取舍。
打开主题
继续阅读
上一篇
Qwen-VLA: Unifying Vision-Language-Action Modeling across Tasks, Environments, and Robot Embodiments
Qwen-VLA 将操作、连续导航、轨迹预测和人类第一视角运动统一为同一 action-and-trajectory prediction 问题;它不是为每个机器人另训策略,而是用 Qwen3.5-4B 与 1.15B 参数 DiT 动作专家共享建模。其关键价值是以 embodiment-aware prompt 保留各平台原生控制语义,并用四阶段训练把语言—动作先验、视觉 grounding、任务对齐和成功率优化串起来。跨操作、导航、真实 OOD 与动态零样本基准的结果表明,这个统一接口并未以明显的 specialist 性能为代价。
下一篇
AHA-WAM: Asynchronous Horizon-Adaptive World-Action Modeling with Observation-Guided Context Routing
AHA-WAM 值得作为实时 WAM 的系统设计案例精读:它展示了世界模型上下文可以跨动作更新复用,并随最新观测校正。仿真平均成功率 92.80%,优化后动作更新达 24.17 Hz;更快的 Flash 达 56.95 Hz,但成功率有所下降。最重要的阅读边界是:实机另有机器人数据预训练,速度收益也包含大量工程优化。