HarnessPAI: An Evolving Harness for Physical AI
HarnessPAI: An Evolving Harness for Physical AI
Xin Wang · Wenhao Wu · Menghao Zhang · Zhi Wang · Kun Shao · Jian Luan · Yang Li · Qing Li 等
一句话结论
HarnessPAI 的核心主张是:Physical AI 的瓶颈不只藏在 VLA/WAM 权重里,也在把感知、语言 grounding、几何推理、动作调用和验证组织起来的执行系统中。它把任务写成可执行程序;单次 rollout 内程序固定、逐步检查、没有在线高层 LLM deliberation;跨 rollout 则由代码轨迹、 rollout 视频和成功契约驱动程序演化,并把失败修复沉淀为按任务图节点检索的技能库。包装冻结的 π0.5 后,LIBERO-PRO 从 34.9% 升至 96.5%;包装 WorldDreamer 后,RoboCasa Atomic-Seen 从 65.0% 升至 92.2%。成功轨迹还能作为无人工标签的扰动场景专家数据,把 π0.5-LIBERO 的 LIBERO-PRO 成功率从 34.9% 微调到 73.7%。
关键词
摘要
中文摘要
Physical AI 旨在构建能感知世界、理解并推理世界、决定如何行动的具身智能体。然而该领域主要聚焦最后一个组成部分:把观测映射到低层控制的动作模型。主流训练配方可能削弱鲁棒行为所需的感知与推理能力,使强动作模型在场景扰动和长时域任务中仍然脆弱。论文提出 HarnessPAI:一个模型与本体无关的 Physical AI Harness 框架,把代码视为组织底层动作原语的可执行、可演化接口。框架区分两个时间尺度:rollout 内在程序层开环执行,由固定程序引导和检查执行;rollout 间闭环演化,用执行反馈修订程序并把失败蒸馏成可复用技能。在桌面机械臂、家用机器人、扫地机器人和腿式行走智能体上,HarnessPAI 不重训底层模型即优于纯动作模型和 code-as-policy 基线:LIBERO-PRO 相比 π0.5 提升 61.6 点,RoboCasa atomic 任务相比 WorldDreamer 提升 27.2 点。程序选定后,rollout 执行无需在线高层 LLM deliberation。除执行外,收敛程序也是廉价可靠的专家数据采集器;用采集数据微调 π0.5 可把 LIBERO-PRO 成功率提升 38.8 点。结果表明,Physical AI 的前沿不仅取决于更强动作模型,也取决于把感知、任务理解与推理、动作执行整合成统一、可验证、反馈驱动系统的可执行 harness。
英文摘要
Physical AI aims to build embodied agents that perceive the world, understand and reason about it, and decide how to act. Yet the field has focused primarily on the last component: the action model that maps observations to low-level controls. The prevailing training recipe can erode the perceptual and reasoning capabilities needed for robust behavior, leaving even strong action models vulnerable to scene perturbations and long-horizon tasks. We introduce HarnessPAI, a model- and embodiment-agnostic Harness framework for Physical AI that treats code as the executable and evolvable interface that organizes the underlying action primitive. The framework separates two timescales: within a rollout, it executes open-loop at the program level, with a fixed program guiding and checking execution; across rollouts, it evolves closed-loop, using execution feedback to revise the program and distill failures into reusable skills. Across desktop robot arms, household robots, a robot vacuum, and a legged walking agent, HarnessPAI improves on both pure action models and code-as-policy baselines without retraining the underlying model: a 61.6-point gain over π0.5 on LIBERO-PRO and a 27.2-point gain over WorldDreamer on RoboCasa atomic tasks. Once a program is selected, rollout execution requires no online high-level LLM deliberation. Beyond execution, the converged program is also a cheap and reliable expert-data collector, and fine-tuning π0.5 on collected expert data lifts success rate on LIBERO-PRO by 38.8 points. Our results suggest that the frontier of Physical AI depends not only on stronger action models, but also on executable harnesses that integrate perception, task understanding and reasoning, and action execution into a unified, verifiable, and feedback-driven system.
直观理解
可以把 HarnessPAI 看成给动作模型套上一层“可版本化的作业程序”。程序不是替代抓取、插入、擦拭这些连续控制能力,而是规定先识别哪个对象、如何计算几何目标、什么时候调用 VLA/WAM、每一步用什么条件验收、失败后怎么恢复。执行时它像一条已编译的生产流程一样运行;开发时它像代码仓库一样被诊断、修补、回归测试和原子发布。这样,模型推理被移出部署关键路径,而语义理解和验证被显式写成可读代码。
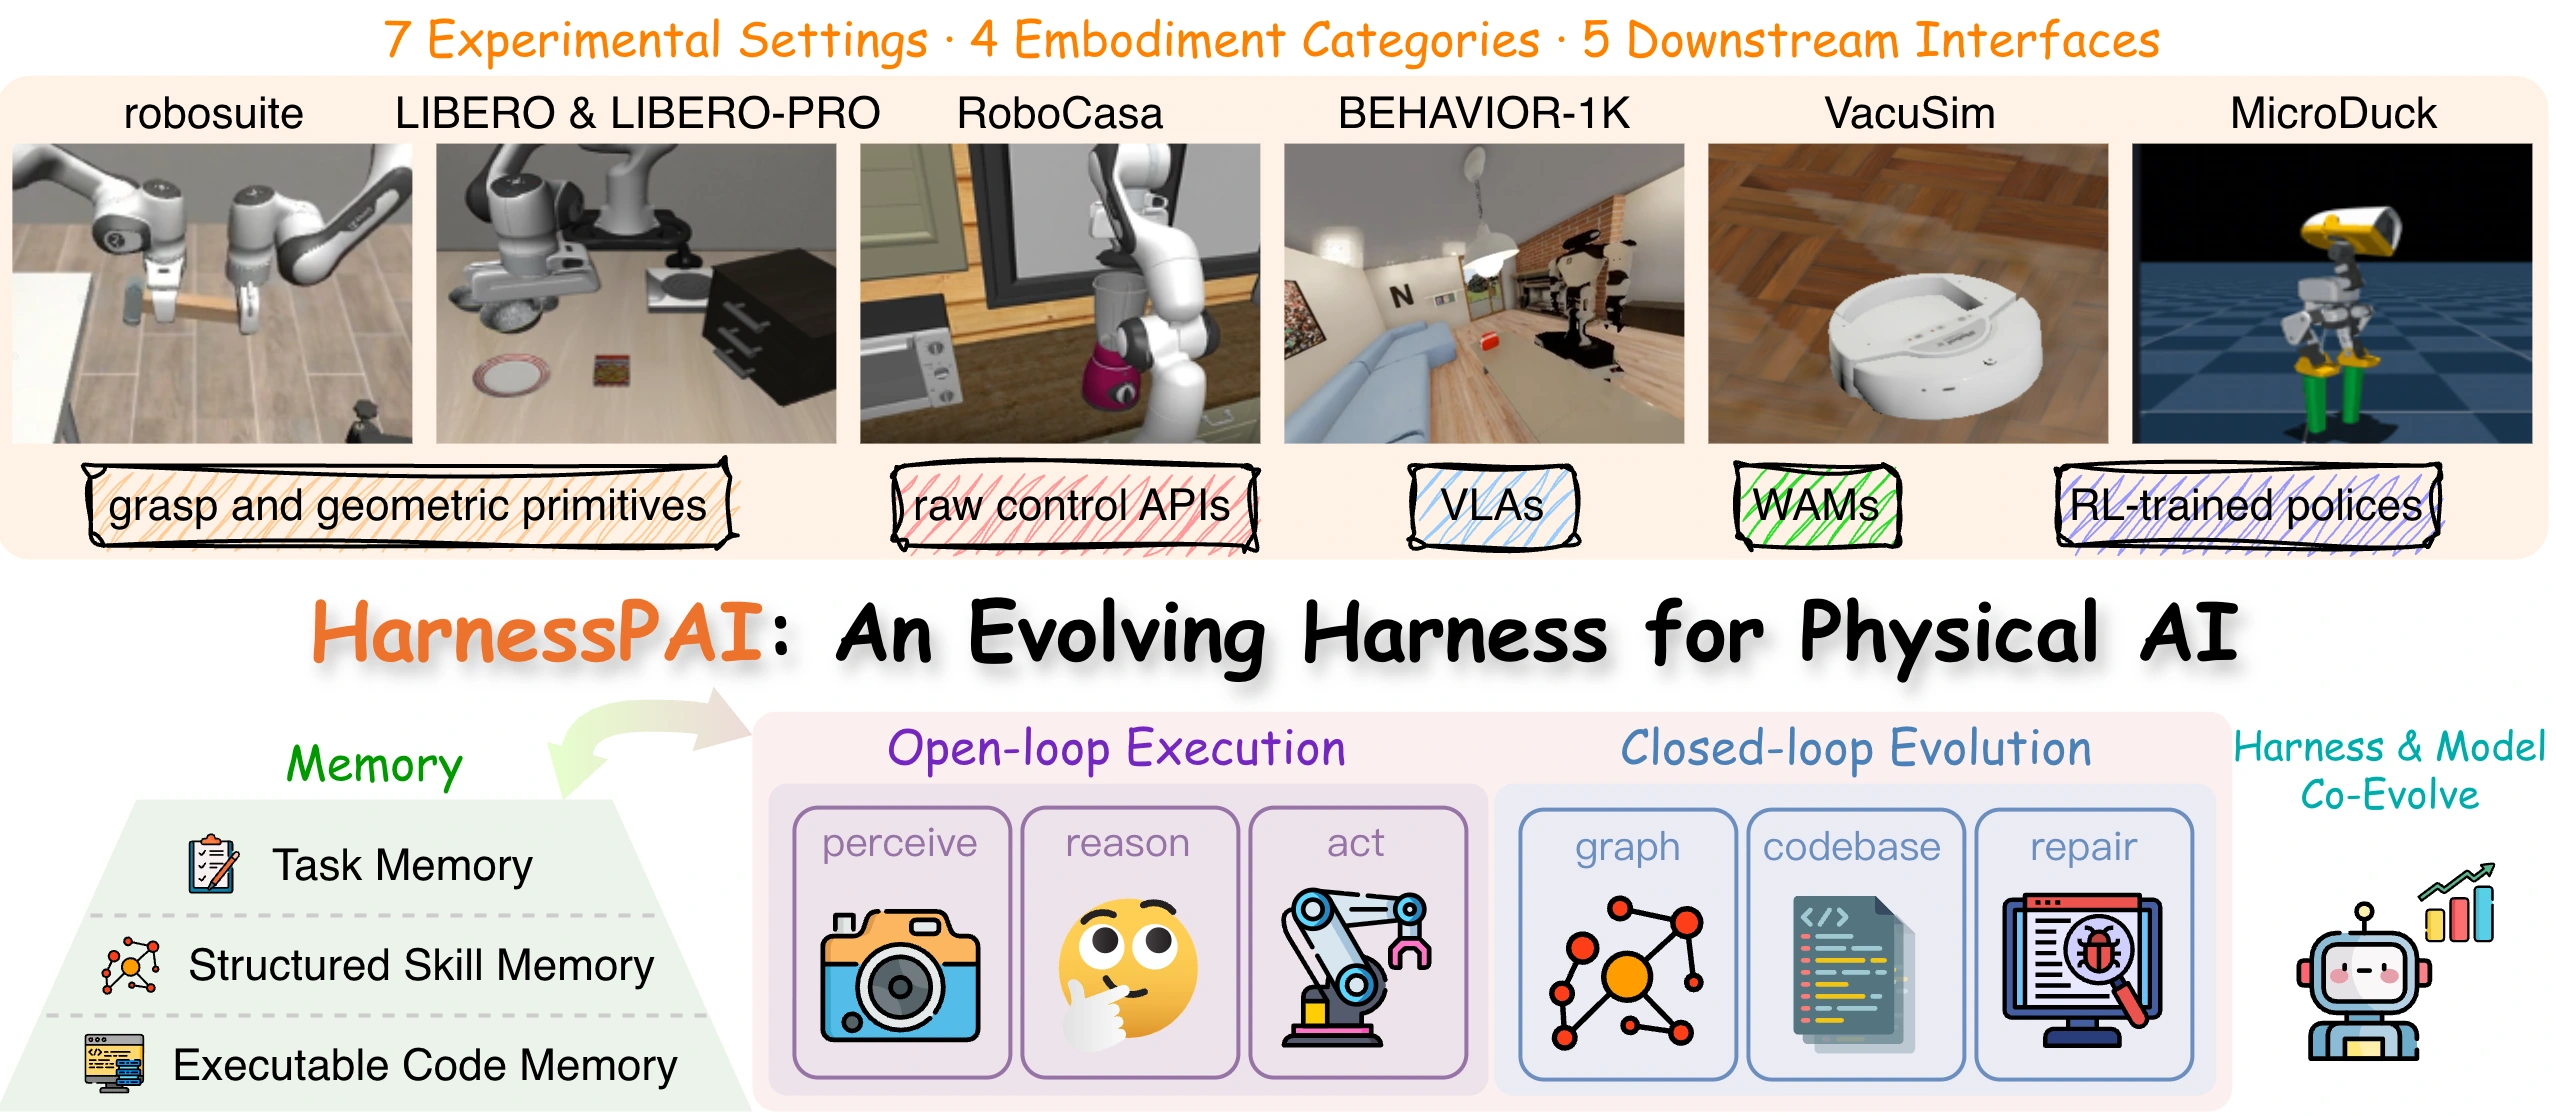
图 1:HarnessPAI 用记忆、开环程序执行和闭环演化连接不同模型与本体;动作模型只是可替换原语之一。
背景与问题
为什么做
Physical AI 需要同时完成感知、任务理解、推理和动作,但当前大量工作把优化重心放在 observation-to-action 的动作模型上。动作训练目标会挤压视觉语言 backbone 的 grounding 与指令理解能力,使强模型在 LIBERO-PRO 的 Swap/Task 扰动下从 96.9% 分别跌到 39.7% 和 30.1%;纯 code-as-policy 又缺乏接触丰富的低层机动性,OpenETA 在 LIBERO 只有 18.3%。这说明单靠“更强 action model”或“更多手写控制代码”都不是完整答案。
问题缺口
已有 harness 与 memory 系统常在执行时反复调用高层 agent,把观察、检索、记忆和重规划留在在线关键路径上;这既昂贵、慢,也让同一任务的推理无法稳定复用。论文需要一个能保留 VLA/WAM 连续控制能力、又把感知/几何/验证编成显式接口的系统,并在任务重复出现时用执行反馈持续修复系统本身,而不是只在上下文里临时积累经验。
方法
方法概述
HarnessPAI 先把一个物理任务编译为代码包:代码负责场景 grounding、几何计算、阶段顺序、动作原语调用、成功检查与恢复;VLA/WAM 只在被委托的语义或接触阶段提供连续动作。开发阶段在多个 seed 和扰动上运行候选代码,由代码 trace、rollout 视频、VLM 诊断和确定性 gate 判断失败;候选修复先经过 pre-flight/probe,再全量回归,全部通过后原子加入代码库。部署阶段复用已验证程序,不再让高层 LLM 每步重想。
核心机制
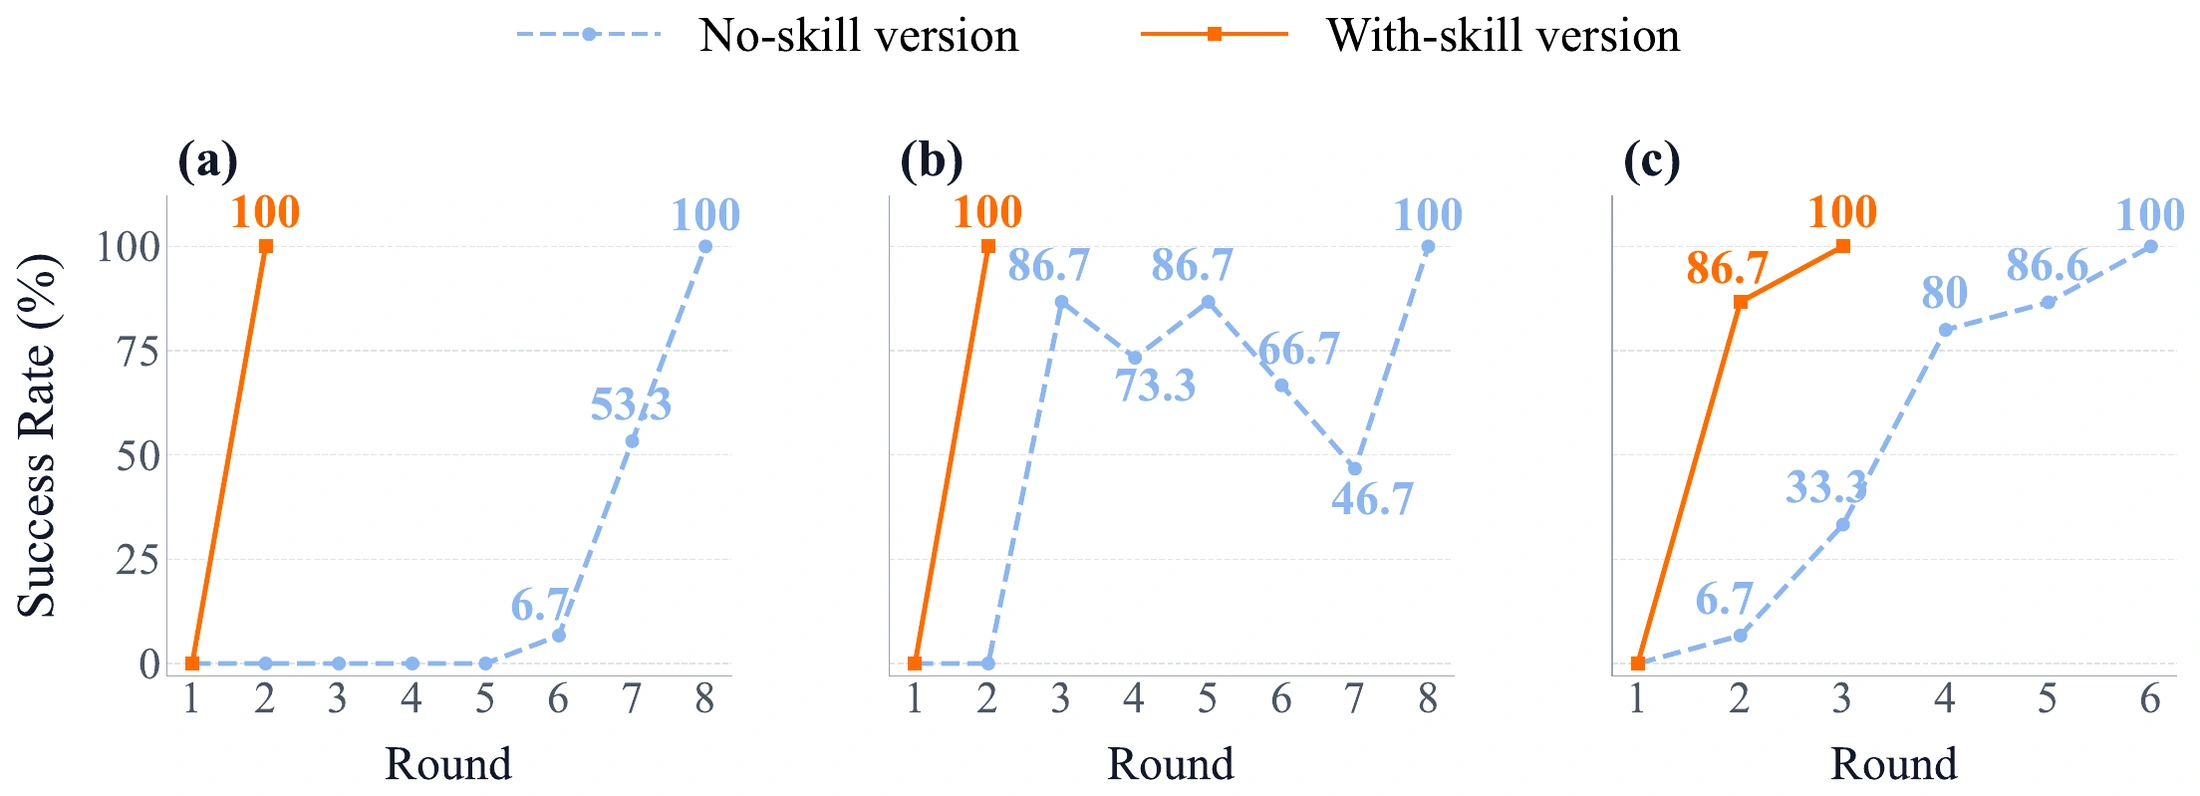
关键在于把“执行”和“改进”分离到两个时间尺度。rollout 内程序固定但并非盲开环:它仍可读取当前观测、调用感知原语并执行预先写好的检查;跨 rollout 才允许改程序。这样既避免在线 agent 循环的延迟和成本,又让失败成为可定位的代码缺陷而不是不可解释的权重漂移。技能库按 workflow node 聚合“问题→修复”,让新任务复用旧任务在 approach/grasp/transport/place 等阶段的修复经验。
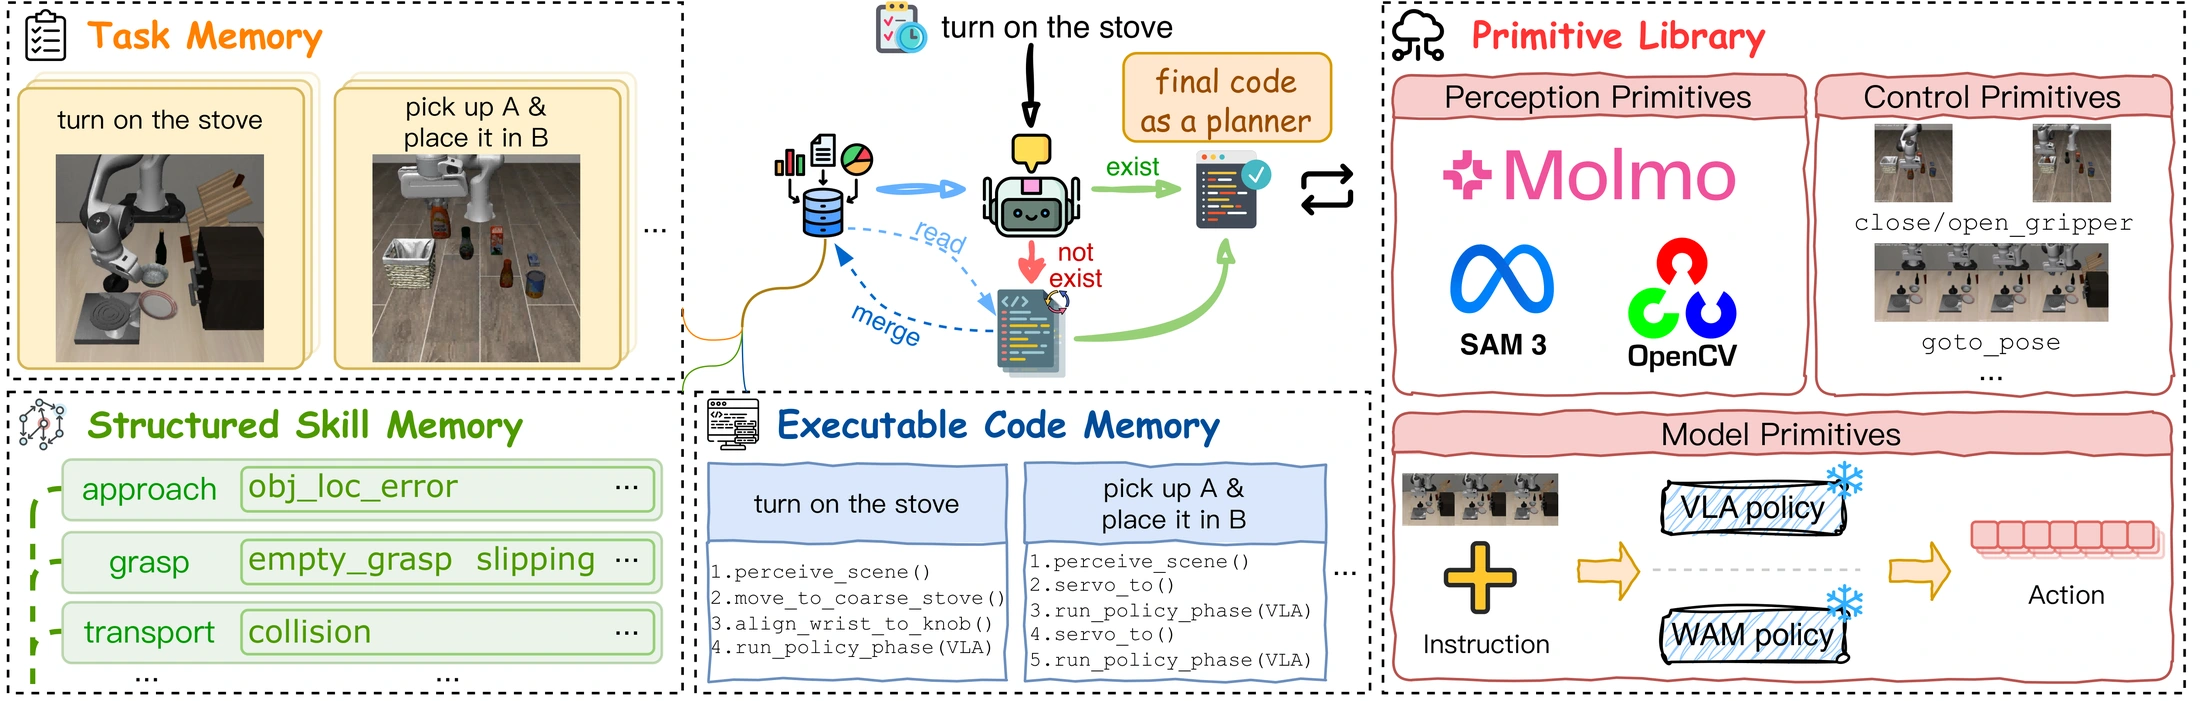
图 2:Task Memory 保存任务入口,Structured Skill Memory 保存节点化失败修复,Executable Code Memory 保存已验证程序;Primitive Library 提供 SAM3/Molmo 感知、控制 API 与 VLA/WAM/PPO 动作原语。
方法拆解
- 三层记忆 + 原语库:Task Memory 匹配已见任务并直接复用代码;Executable Code Memory 存储经验证程序;Structured Skill Memory 以任务图节点为索引存储修复技能。Primitive Library 把感知、控制和模型原语放在同一抽象层,动作模型不是系统中心。
- 混合 rollout:grounding 由分割+几何代码完成;approach 用 Cartesian servo 与 Pyroki IK rescue;grasp/place 等语义困难阶段交给 VLA;transport 回到固定代码。代码补 VLA 的 V/L 与验证,VLA 补代码的 A。
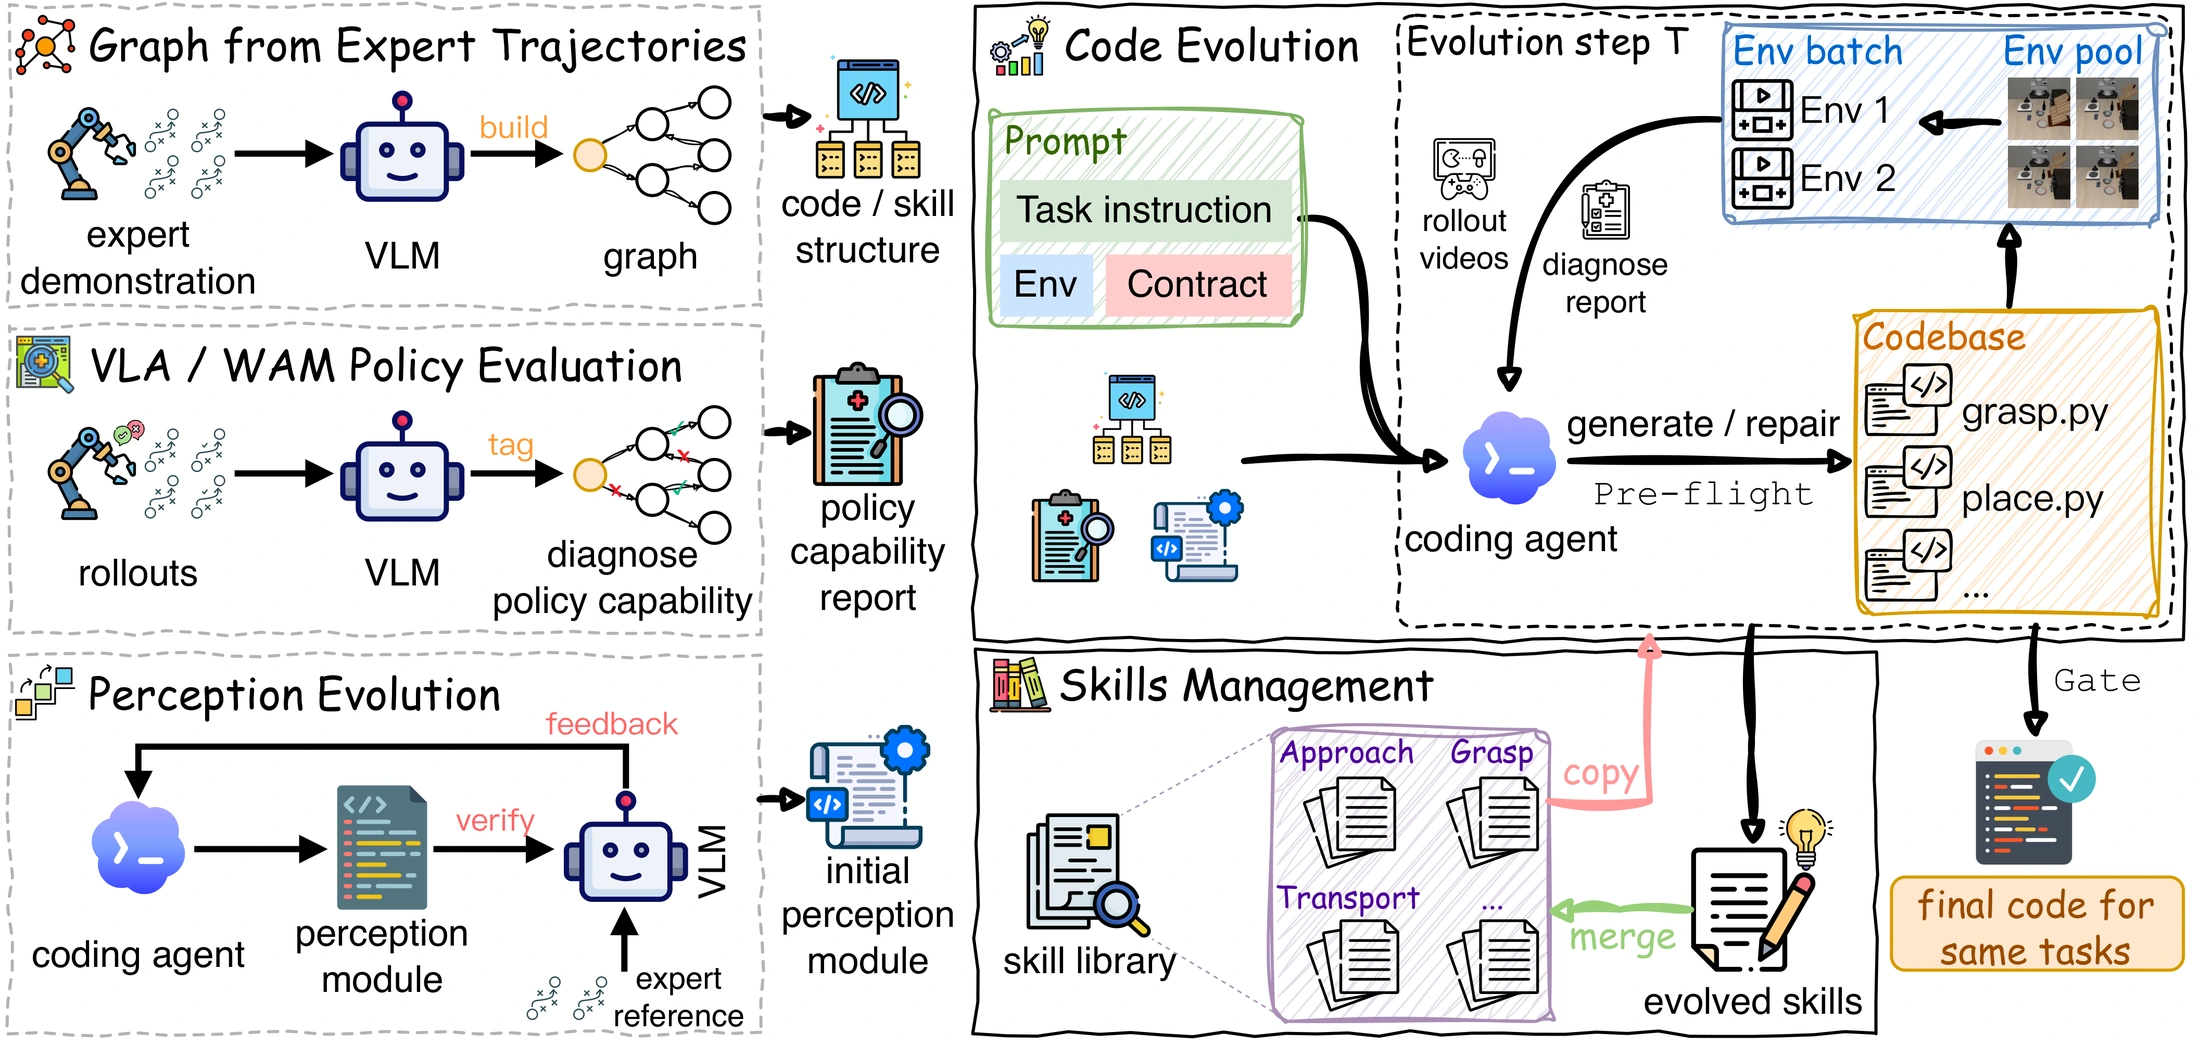
- 可选初始化 + 必经演化环:有专家视频时 VLM 抽 workflow graph;有 VLA/WAM 时先用能力评估判断哪些节点需要代码接管;感知依赖任务可先演化 SAM/Molmo 代码。所有任务仍必须进入主演化环。
- 成功契约与独立诊断:作者、诊断器和 reviewer 都收到同一份 success contract,明确目标条件、终态以及“程序正常退出/到达终态/高 dense reward/自我宣称收敛”不算成功。GPT-5.6-sol 负责写码和综合,Gemini-3.5-Flash 看视频做节点级诊断,另有无需模型的 milestone-prefix gate。
- 安全发布与技能沉淀:候选代码在隔离副本上运行;pre-flight 检查接口崩溃,probe 只复测上轮失败 seed,随后全量回归防退化。全部通过才原子 promote;失败被蒸馏为节点上的 problem-repair pair。
关键要点
- “开环”指程序层不在 rollout 中被高层模型重写,不等于不读观测;程序内部仍可用感知、检查和预定义恢复。
- 代码的价值是可执行、可检查、可诊断、可版本化;VLA/WAM 的价值是局部语义动作和接触技能,二者互补而非替代。
- 收敛后的程序还能在无人工示范的扰动场景生成成功轨迹,用 success gate 过滤后作为专家数据微调底座;这是单向 model feedback,不是论文已验证的 harness-model 共同演化。
结果
结果速览表
| 实验 | 基线 | HarnessPAI | 变化/说明 |
|---|---|---|---|
| robosuite 七任务平均 | ASPIRE 81.0% | **96.3%** | +15.3 点;五任务 100%,Insert 83% |
| LIBERO 三套平均 | π0.5 96.9%;Harness VLA 97.0% | **98.1%** | +1.2/+1.1 点;基线协议不完全一致 |
| LIBERO-PRO Swap/Task 平均 | π0.5 34.9% | **96.5%** | +61.6 点;比 Harness VLA CC +8.8 点 |
| RoboCasa Atomic-Seen | WorldDreamer 65.0% | **92.2%** | +27.2 点;统一评估 WorldDreamer 与 HarnessPAI |
| DreamZero 零样本换后端 | Swap 0.6%,Task 9.6% | **73.4% / 84.4%** | π0.5 harness 不重演化直接换 DreamZero |
| B1K radio / soda can 适应后 | ASPIRE 88% / 88% | **100% / 92%** | 零-shot 为 84% / 72%,8 轮再演化 |
| VacuSim 覆盖率(40×40 / 25×25) | 4.90% / 11.72% | **63.76% / 53.92%** | furnished 图物理可清洁上限 73.06% |
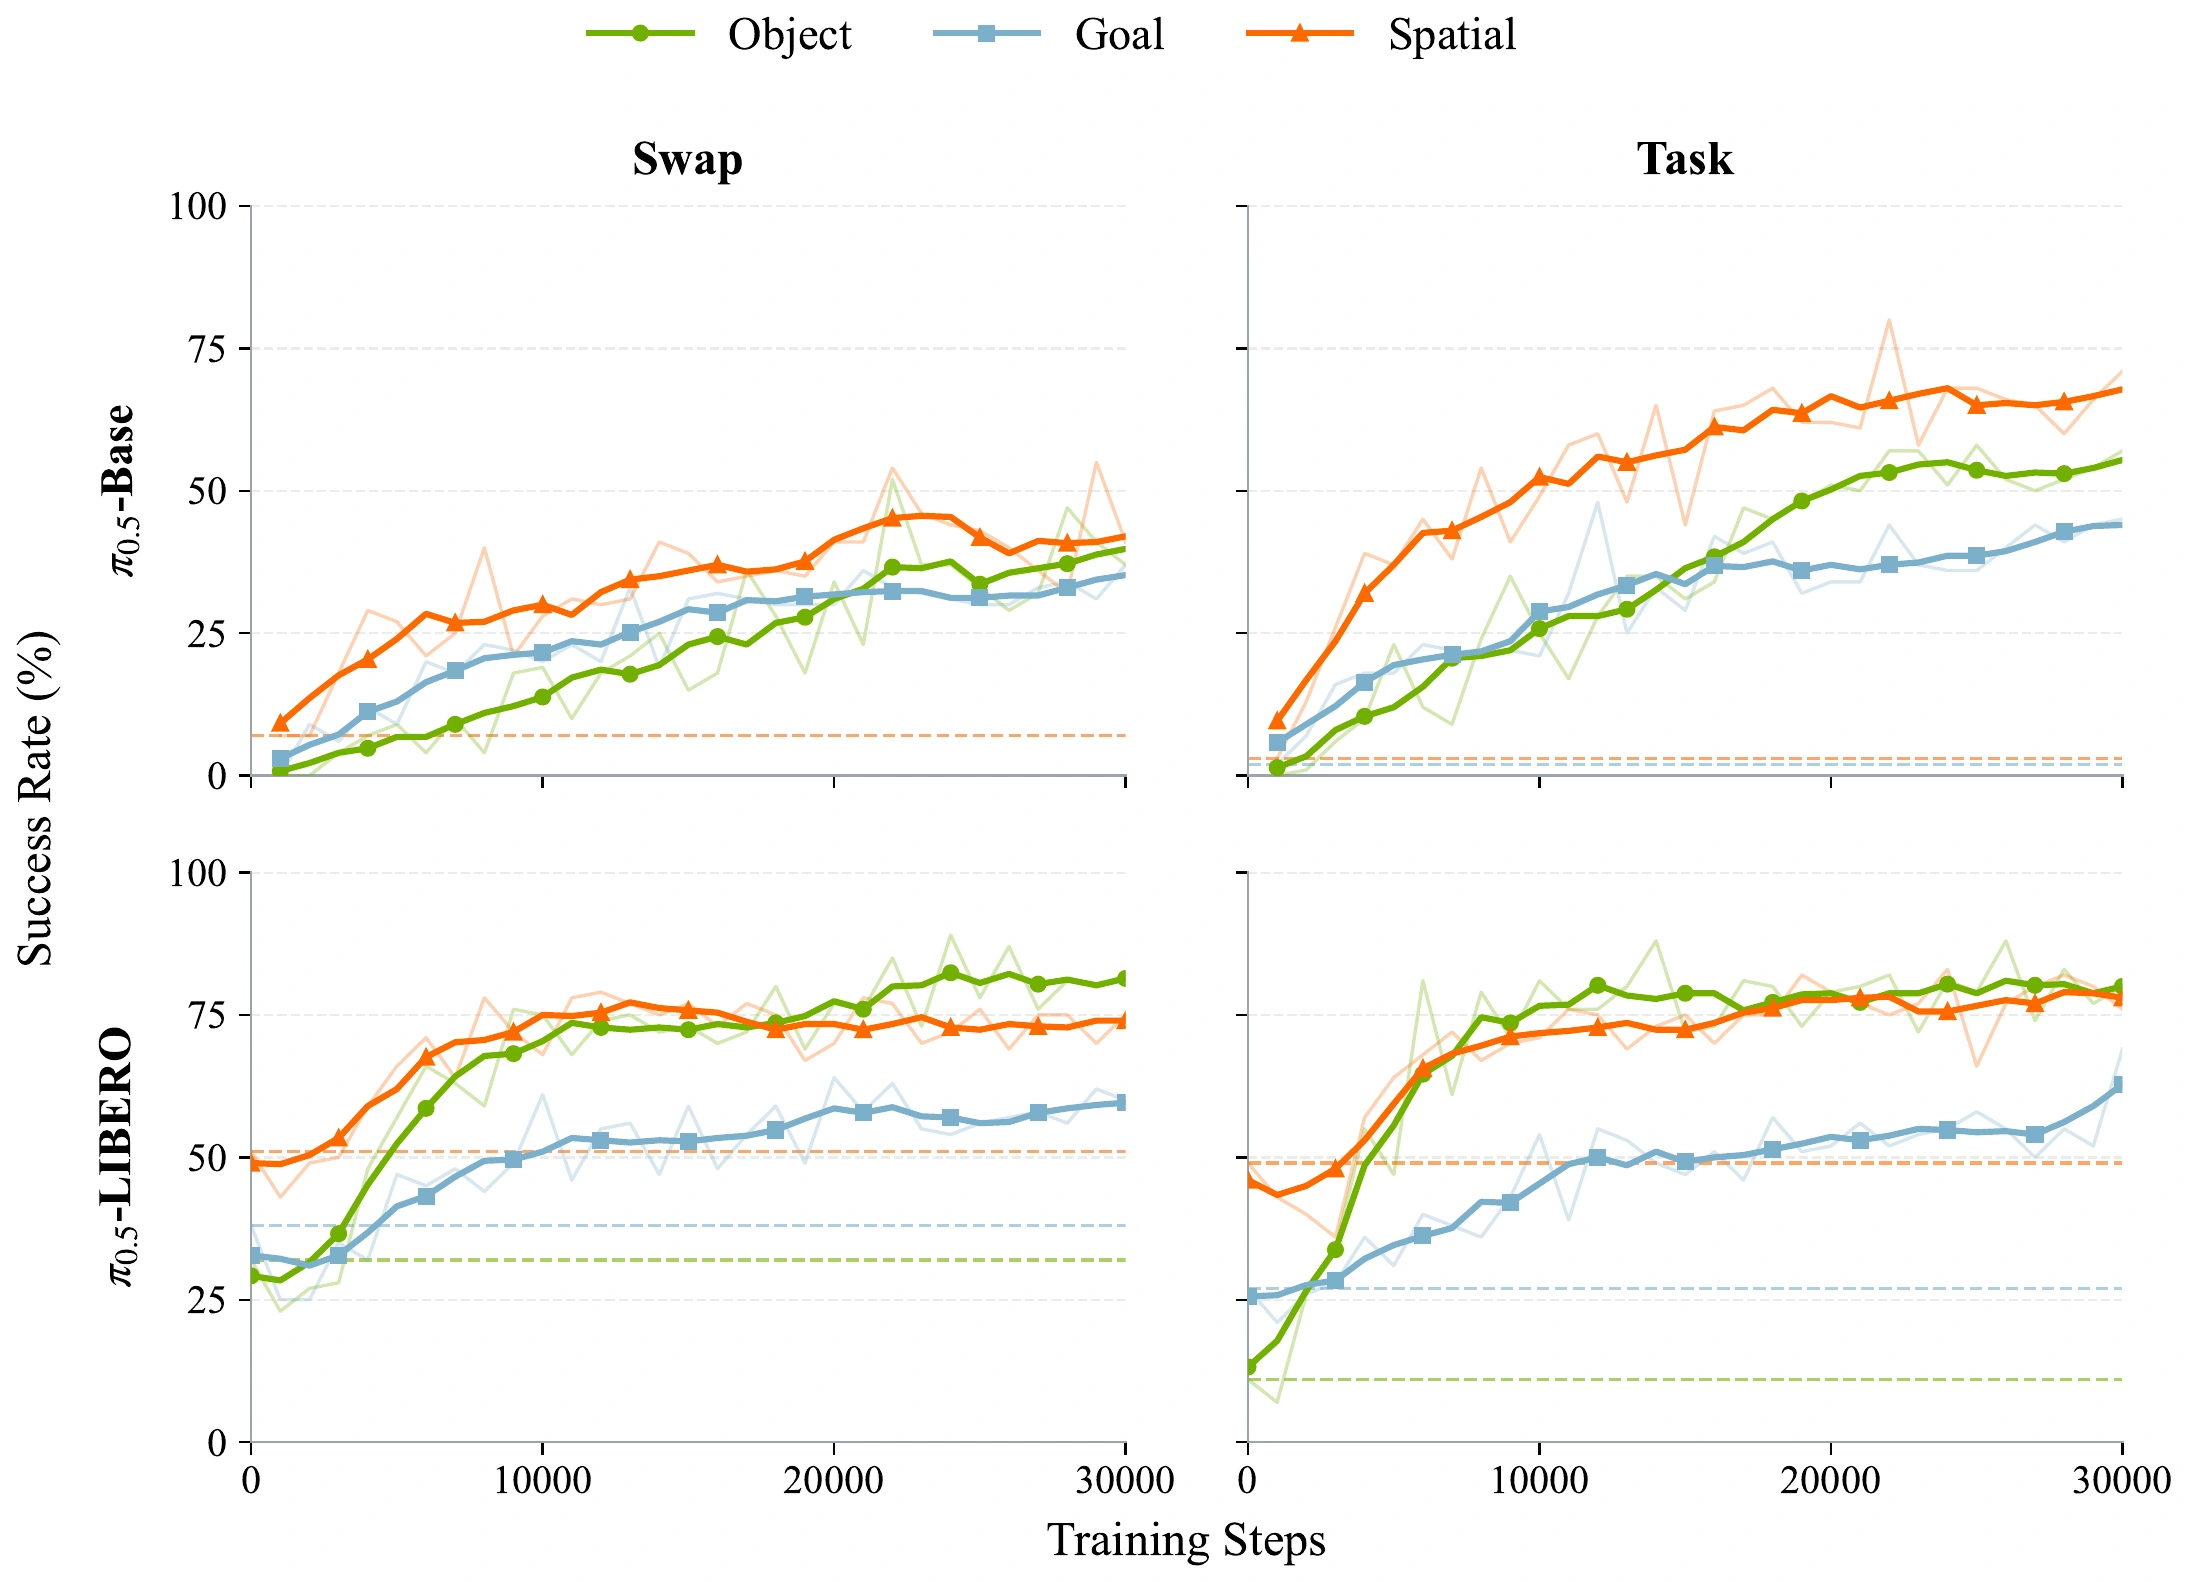
| 轨迹回流微调 π0.5-LIBERO | 34.9% | **73.7%** | +38.8 点;π0.5-Base 接近 0 → 53.3% |
| 每 rollout 时间(Swap / Task) | Harness VLA 1134.9s / 978.1s | **49.2s / 53.2s** | serial 23.1×/18.4×;7 GPU 7.7s/8.3s |
洞察
- 这篇论文把“泛化压力”从参数更新转移到系统接口:VLA/WAM 负责已有原子能力,代码重新提供被动作训练削弱的视觉 grounding、语言解释、几何约束和阶段验收。LIBERO-PRO 的收益主要来自修复任务框架,而不是让底座更强。
- 可复用性来自表示形式。markdown 记忆或在线上下文只能被检索和阅读;可执行代码能直接运行、回归、diff 和原子发布。节点化 skill memory 又把修复经验从单任务文本提升为跨任务的阶段级索引。
- 成功契约是方法成立的关键:如果让写码模型同时定义成功、执行成功和判断成功,闭环会自我确认。论文把 success contract 注入 writer/diagnoser/reviewer,并用外部 VLM 与 deterministic gate 分离诊断和编辑权。
- 后训练实验揭示了一个实用的数据来源:当没有扰动场景人工示教时,已验证代码可以在这些场景生成 success-filtered demonstrations。它解决的是“专家数据缺失”,而不是证明所有代码启发式都能安全蒸馏进权重。
和已有方法的关系
- 相比 pure VLA/WAM,HarnessPAI 不要求底座自己完成长时程重规划和扰动 re-grounding,而是在外部恢复 V/L 能力;但底座若完全没有 grasp/press 等原子能力,代码也无法组织出有效动作。
- 相比 code-as-policy,它没有用 API 取代学习策略,而是把 VLA/WAM 保留为接触丰富阶段的 primitive,因此避免了 OpenETA 那种 18.3% 的低层能力塌陷。
- 相比每步调用 agent 的 Harness VLA,它把推理固化到代码中,把 LLM 移出部署关键路径;这带来数量级速度和成本差,但把创新压力转移到开发期程序演化。
- 相比 robot self-improvement 中的想象练习场或失败状态纠正,HarnessPAI 的改进对象先是外部程序;模型权重更新只发生在成功轨迹回流之后,且论文未继续迭代改进后的模型。
可借鉴点
- 为重复任务维护“任务图节点→失败模式→修复代码”的结构化经验库,比堆平铺笔记或长上下文更容易精确检索和回归验证。
- 给 agent 生成系统设置不可由生成者自行解释的 success contract,并把 writer、diagnoser、gate 分开,是防止代码自我修复循环漂移的基本工程约束。
- 在 VLA 应用中显式列出哪些阶段由感知/几何代码负责、哪些阶段交给动作模型,可审计地划分能力边界;这个接口也便于日后替换 π0.5、WorldDreamer 或 PPO。
- 把已验证系统当作数据采集器,在分布变化处自动生成带硬成功信号的轨迹,比人工补采扰动示教更便宜。
风险与判断
局限
- 目标场景是可重复、可开发、可验证的任务,不是通用 one-shot 新任务求解器;论文也明确说明性能依赖可用原语、感知质量、成功契约和演化预算。
- 主表的 LIBERO/RoboCasa 基线混合了原论文结果和自评结果,评估 seed、场景和协议不完全一致;Harness VLA 对比尤其不能视为严格受控消融。
- LIBERO 与 LIBERO-PRO 的 50-seed 评估包含 15 个开发 seed;robosuite 在 seeds 101–125 演化、1–100 评估是 held-out,但不同 benchmark 的泛化压力不同。
- 技能库效果主要由三个 LIBERO-PRO Object 代表任务的开发批次曲线支持,缺少更大规模 held-out 任务集、置信区间和显著性检验;这些曲线不能直接证明跨任务迁移。
- “零 API 成本”只指执行期高层 LLM 调用,不覆盖感知、动作模型推理、仿真、硬件、程序开发和多 GPU 并行;7 GPU 加速也不是单机部署成本。
- 程序和 success contract 可能把任务特定假设、感知错误或安全边界写进代码;论文没有提供端到端形式化安全证明,也不应把阶段检查等同于现实部署安全。
- 后训练仅在 LIBERO-PRO 的 seed 40–49 测试,最佳 checkpoint 汇报缺少重复实验;harness 与模型没有双向共同演化。
适用场景
- 同类任务重复执行、允许开发期 rollout 与回归验证的机器人自动化场景,例如固定家庭任务、清洁策略、工业装配流程或可仿真验证的操作。
- 已有可用 VLA/WAM/PPO/API 原语,但模型在语言 grounding、布局变化、阶段顺序或验收上不稳定,需要显式系统层修复。
- 需要为扰动/长尾场景自动生成成功轨迹以继续微调动作模型,且环境能提供可靠成功判定。
最终判断
- 值得重点跟踪。HarnessPAI 提供了一个清晰的系统层路线:不要把所有鲁棒性都压进动作模型权重,而是把可验证的任务知识编译成代码、技能和可回流数据。它在多 benchmark、多后端、多本体上的增益和执行成本优势很有说服力。
- 但应把 96.5%/92.2% 读成“重复任务 + 显式验证 + 开发期演化”的系统级结果,而不是 VLA 泛化问题已被解决。后续关键检验是真实机器人、完全 held-out 任务、程序开发总成本、感知失败下的安全边界,以及 harness-model 双向迭代是否稳定。
相关主题
继续阅读
上一篇
Grounded Action Model: 3D Grounding as a Foundation for Robotics
Grounded Action Model(GAM)提出“3D grounding 是机器人基础模型预训练基础”的路线:不用语言生成或视频生成为主骨干,而是用冻结的 promptable 3D 检测器 WildDet3D 把语言、点击或框统一解析为任务对象的 2D 框、3D 框、深度图和视觉特征。动作头只学习如何作用于这些已定位对象,并用目标图像 token、点云检测 token、机器人状态历史和语言语义预测关节位置动作块。在只见过 clean scene 示范的条件下,GAM 于 RoboTwin 2.0 randomized 达 47.62%,平均 55.29%;LIBERO-PRO 16 项扰动平均 0.61;真机 YAM 视觉扰动下保留 17/20 成功,Franka 长程/记忆任务 OOD step completion 49.8%。
下一篇
See to Reach, Feel to Grasp: Learning A Blind Grasp Reflex for Anthropomorphic Robotic Hands
值得记住的是一种可复用的手部抓握接口:机械臂负责把手送到物体附近,手只凭关节反馈完成接触适应,并主动报告何时可以开始搬运。仿真中的动态与位置泛化明显优于本文适配的端到端基线,但真机只是多样性和组合能力演示,没有重复试验成功率,不能把它当成已验证的通用可靠抓手。