OpenVLA: An Open-Source Vision-Language-Action Model
OpenVLA: An Open-Source Vision-Language-Action Model
Ted Xiao · Ashwin Balakrishna · Suraj Nair · Rafael Rafailov · Ethan Foster · Pannag Sanketi · Quan Vuong · Thomas Kollar 等
一句话结论
OpenVLA 的价值不只是开源一个 VLA 模型,而是把可训练、可微调、可部署的完整开源机器人大模型工作流真正落到了实践层面。
关键词
摘要
中文摘要
基于互联网规模视觉语言数据和多样化机器人示范进行预训练的大模型,有可能改变机器人学习新技能的方式:我们不再需要从零开始训练新行为,而是可以通过微调 vision-language-action(VLA)模型来获得更稳健、更具泛化性的视觉运动控制策略。然而,VLAs 在机器人领域的广泛采用一直受限于两个问题:其一,现有 VLA 大多是闭源的,公众难以访问;其二,已有工作没有系统探索如何高效微调 VLA 以适配新任务,而这恰恰是实际采用的关键。为了解决这两个问题,作者提出 OpenVLA,一个 70 亿参数、开源的 VLA 模型,训练数据来自 97 万条真实机器人示范。OpenVLA 以 Llama 2 为语言骨干,并结合融合 DINOv2 与 SigLIP 特征的视觉编码器。得益于更丰富的数据和新的模型组件,OpenVLA 在通用操作任务上表现强劲:在跨 29 个任务和多个机器人平台的评测中,它以少 7 倍参数量的代价,在绝对任务成功率上比闭源模型 RT-2-X(55B)高出 16.5%。作者进一步展示,OpenVLA 可以有效微调到新机器人设置上,特别是在多对象、多任务和强语言 grounding 环境中具有较强泛化能力,并比从零训练的 Diffusion Policy 高出 20.4%。此外,作者还讨论了计算效率:OpenVLA 可以通过低秩适配方法在消费级 GPU 上完成微调,并通过量化高效部署而几乎不损失下游成功率。最后,作者开源了模型权重、微调 notebook 和支持大规模 Open X-Embodiment 数据训练的 PyTorch 代码库。
英文摘要
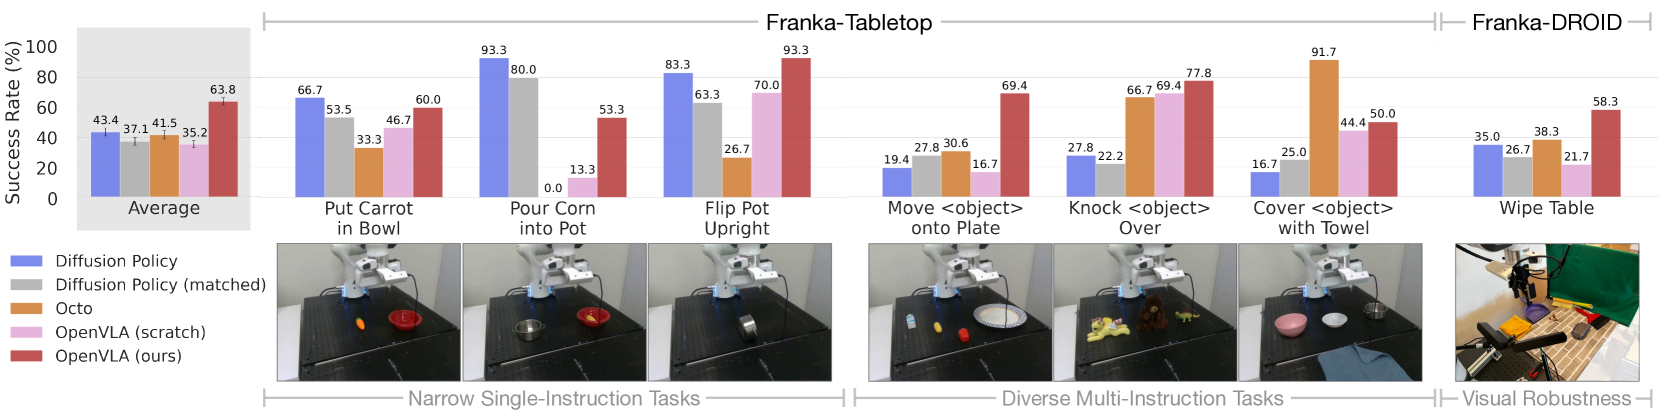
Large policies pretrained on a combination of Internet-scale vision-language data and diverse robot demonstrations have the potential to change how we teach robots new skills: rather than training new behaviors from scratch, we can fine-tune such vision-language-action (VLA) models to obtain robust, generalizable policies for visuomotor control. Yet, widespread adoption of VLAs for robotics has been challenging as 1) existing VLAs are largely closed and inaccessible to the public, and 2) prior work fails to explore methods for efficiently fine-tuning VLAs for new tasks, a key component for adoption. Addressing these challenges, we introduce OpenVLA, a 7B-parameter open-source VLA trained on a diverse collection of 970k real-world robot demonstrations. OpenVLA builds on a Llama 2 language model combined with a visual encoder that fuses pretrained features from DINOv2 and SigLIP. As a product of the added data diversity and new model components, OpenVLA demonstrates strong results for generalist manipulation, outperforming closed models such as RT-2-X (55B) by 16.5% in absolute task success rate across 29 tasks and multiple robot embodiments, with 7x fewer parameters. We further show that we can effectively fine-tune OpenVLA for new settings, with especially strong generalization results in multi-task environments involving multiple objects and strong language grounding abilities, and outperform expressive from-scratch imitation learning methods such as Diffusion Policy by 20.4%. We also explore compute efficiency; as a separate contribution, we show that OpenVLA can be fine-tuned on consumer GPUs via modern low-rank adaptation methods and served efficiently via quantization without a hit to downstream success rate. Finally, we release model checkpoints, fine-tuning notebooks, and our PyTorch codebase with built-in support for training VLAs at scale on Open X-Embodiment datasets.
直观理解
可以把 OpenVLA 理解成一个把视觉输入、语言指令和机器人动作统一进同一生成框架里的大模型底座,然后你可以像调教基础模型一样去微调它,让它适配新的机器人和任务。
背景与问题
为什么做
机器人领域已经开始从单任务策略转向可复用的基础模型路线,而 VLA 正是把视觉、语言和动作统一到同一模型里的代表方向。
问题缺口
作者要解决的核心问题不是再做一个更大的机器人模型,而是如何给社区提供一个真正可用的开源 VLA:既要有足够强的通用操作能力,又要能在新机器人和新任务上高效微调,还要在部署成本上可接受。
方法
方法概述
OpenVLA 是一个 70 亿参数的开源 VLA 模型,目标是让机器人领域拥有一个既能和闭源大模型竞争、又真正可微调和可部署的通用操作模型基座。
核心机制
OpenVLA 建立在 Llama 2 语言模型之上,用融合 DINOv2 和 SigLIP 的视觉编码器提取观察特征,再将视觉与语言上下文统一映射到动作生成流程中,从而实现图像、语言、动作的一体化建模。
方法拆解
- 模型主体由视觉编码器、视觉到语言空间的投影层,以及 Llama 2 语言骨干组成,最终直接预测 7 维机器人控制动作。
- 训练阶段使用 97 万条真实机器人示范,并利用 Open X-Embodiment 风格的数据混合,强调跨平台和跨任务的数据多样性。
- 作者不仅训练基础模型,还系统研究了新机器人设置下的数据高效适配、LoRA 等参数高效微调,以及量化后的低内存推理。

关键要点
- OpenVLA 把机器人基础模型是否必须闭源这个问题正面回答了:不必。
- 论文最强的贡献不只是模型本身,而是把训练、适配、部署三件事连成了一条可复现的开源链路。
结果
- 在 29 个任务和多个机器人平台上,OpenVLA 以 7 倍更小的参数规模,相比 RT-2-X 获得 16.5% 的绝对成功率提升。
- 在新机器人设置的微调实验中,OpenVLA 在多对象和强语言 grounding 场景下表现出比 Diffusion Policy 更强的泛化,最高绝对提升达到 20.4%。
- 参数高效微调实验表明,LoRA 在训练参数只占 1.4% 的情况下,就可以达到接近全量微调的效果。
- 量化实验表明,4-bit 推理几乎不损伤成功率,却能显著降低显存占用。


结果速览表
| 指标 | OpenVLA | 结论 |
|---|---|---|
| 模型规模 | 7B | 明显小于 RT-2-X 55B |
| 通用操作成功率 | +16.5% vs RT-2-X | 闭源强基线之上 |
| 微调相对 Diffusion Policy | +20.4% | 新设置适配更强 |
| LoRA 训练参数占比 | 1.4% | 参数高效微调可行 |
| 量化推理 | 4-bit 几乎无损 | 部署成本更低 |
洞察
- 这篇论文真正改变的是机器人社区的研发起点:以后大家不必总从零开始训练策略,而可以围绕一个开源 VLA 基座持续累积能力。
- OpenVLA 的价值不只在性能,而在它把基础模型、适配与部署变成了可被社区继承和复用的公共资产。
和已有方法的关系
- 相对 RT-2-X 这类闭源大模型,OpenVLA 更强调开放性和可复现性。
- 相对 Diffusion Policy 这类从零训练的策略模型,OpenVLA 的核心优势是把基础模型预训练带来的迁移性引入机器人控制。
可借鉴点
- 如果一个模型想成为领域基座,必须同时解决训练、微调和部署,而不是只在单个 benchmark 上赢。
- 视觉编码器融合和参数高效微调在具身场景里是非常务实的技术路线。
风险与判断
局限
- 论文的主要贡献偏基础设施和生态层面,因此它并不自动解决真实机器人上的安全、延迟、数据偏差和执行鲁棒性问题。
适用场景
- 多平台通用操作、具身智能研究基座,以及需要快速适配新机器人设置的实验室环境。
最终判断
- 这篇论文更像一个开源机器人基座项目,而不只是单篇模型论文。
相关主题
Vision-Language-Action
VLA/WAM 从开放基座、多源数据、在线精修和长时程记忆,继续扩展到新感官模态、隐式空间表征对齐、几何世界建模、模块化世界—动作预训练、训练期物理模态蒸馏、动作接触后果预测与执行期闭环。
打开主题
继续阅读
上一篇
Causal Confusion in Imitation Learning
这篇 NeurIPS 2019 论文值得作为模仿学习和历史记忆设计的基础阅读:更多观测可能让策略更容易找到专家数据里的捷径,因此离线预测改进并不保证闭环控制改进。作者把这种失效称为因果误识别,并证明少量有针对性的交互可以在受控基准上修复它。论文的重要价值是诊断框架和干预思路;它没有验证面向真实驾驶或现代大规模 VLA 的通用解决方案。
下一篇
TacDiffusion: Force-domain Diffusion Policy for Precise Tactile Manipulation
TacDiffusion 把扩散策略从常见的位姿/关节动作域移到六维力域:模型根据外部 wrench、内部 wrench 和末端速度生成前馈 wrench,动态系统滤波器再把 50–500 Hz 的模型输出平滑升频到 1 kHz,交给阻抗控制器执行。最佳的 DF3 在四种未见几何上的平均成功率为 95.7%,高于行为树专家基线的 83.3%;但更大的 DF4 虽然离线损失最低,却因只有 51.2 Hz 的推理频率而显著退化。这篇论文最强的结论不是“模型越大越好”,而是力策略的预测质量必须与控制带宽一起优化。